
Knowledge Graph AI: як він керує бізнесом
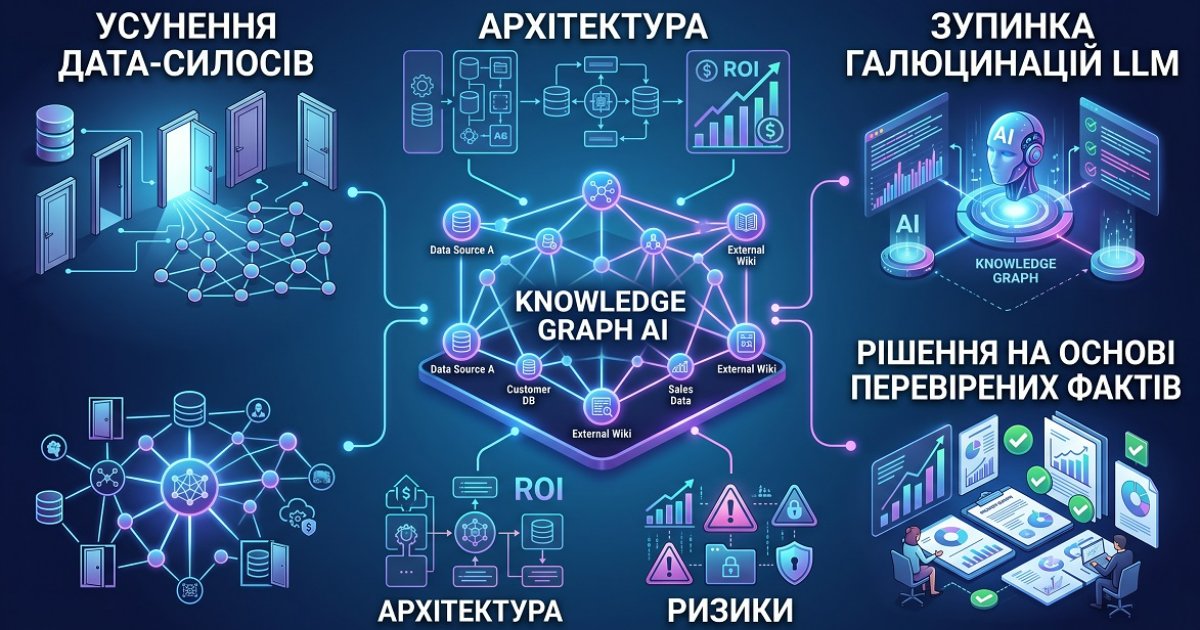
Knowledge Graph AI і GraphRAG усувають дата-силоси, зупиняють галюцинації LLM і дають бізнесу рішення на основі перевірених фактів. Архітектура, ROI, ризики.
Коли дані знають більше, ніж ваша команда
Менеджер із закупівель подає запит на затвердження постачальника у вівторок вранці. Запит торкається шести систем — ERP, реєстру відповідності, бази контрактів, санкційного списку, черги фінансового погодження і календаря CEO. Кожна система тримає фрагмент відповіді. Жодна з них не розмовляє з іншою.
У п'ятницю запит досі лежить у чиїйсь поштовій скриньці. Не тому що людина ледача — а тому що архітектура даних змушує її бути диспетчером між машинами, які вже мають усе необхідне. Саме цю проблему вирішує Knowledge Graph AI. І те, як саме він це робить, варто розібрати детально.
Ідея графу знань обманливо проста: замість того щоб зберігати дані в ізольованих таблицях, ви моделюєте їх як мережу сутностей і зв'язків. Клієнт пов'язаний зі своїми контрактами, контракти — з історією платежів, платежі — зі статусом відповідності контрагента, а той — із санкційним списком, що оновлюється в реальному часі. Кожен вузол знає своїх сусідів. Кожен запит проходить крізь смисл, а не зіставляє стовпці.
Коли поверх цієї структури додають велику мовну модель — архітектура, яку зараз широко називають GraphRAG — отримуєш щось якісно інше, ніж звичайний AI-асистент. Модель перестає вгадувати і починає міркувати на основі перевірених фактів.
Чому стандартний AI ламається без графу
Більшість корпоративних AI-впроваджень упираються в одну й ту саму стіну через шість місяців: модель дає впевнені відповіді, які виявляються хибними. За даними Glean, 77% компаній стурбовані галюцинаціями AI, а 47% корпоративних користувачів у 2024 році прийняли щонайменше одне важливе рішення на основі вигаданого контенту. Це не проблема якості моделі — це проблема архітектури даних.
Великі мовні моделі галюцинують, коли заповнюють прогалини в контексті статистичними здогадками. Граф знань усуває цю прогалину: він надає перевірений, структурований за зв'язками контекст для кожного запиту. Коли модель отримує такий контекст на вході, вона генерує відповіді з фактів, а не з розподілу ймовірностей.
Різниця між AI-асистентом, що вгадує, і тим, що міркує, — не в моделі. Вона в тому, на чому модель стоїть.
Структурне обмеження векторних баз даних робить це наочним. Векторний пошук знайде документи, де згадуються "Іван Петренко" і "шахрайство з рахунками", бо вони семантично близькі. Граф знань покаже, що Іван Петренко є бенефіціарним власником трьох компаній, дві з яких мають спільну юридичну адресу із санкційною структурою, а транзакція минулого четверга їх пов'язує — і все це за один прохід. Саме такий рівень аналізу потрібен командам з комплаєнсу, аналітикам з шахрайства і менеджерам із закупівель.
Gartner розмістив корпоративні графи знань на "Slope of Enlightenment" у своєму AI Hype Cycle 2024 — сигнал того, що технологія перейшла від хайпу до вимірюваної виробничої цінності. Водночас Gartner попереджає: складність інтеграції реальна. Організації, що будують зараз, отримають цю компетенцію саме тоді, коли вона стане стандартом ринку.
Податок на дата-силоси
До будь-якого AI-шару є фундаментальніша проблема, яку більшість керівників недооцінюють. За даними звіту Metaphacts за 2024 рік, 47% фахівців витрачають від однієї до п'яти годин на день на пошук конкретної інформації — не на її аналіз, а просто на пошук. Gartner оцінює збитки від низької якості даних щонайменше у $12,9 млн на рік. IDC ставить вплив дата-силосів на виручку до 30% річного доходу.
Це не абстрактні цифри. Вони відображають накопичену вартість систем, які будувалися для зберігання даних, а не для їх обміну. Граф знань — це сполучна тканина поверх наявних сховищ: він не замінює ERP чи CRM, він вперше змушує їх розмовляти між собою.
Як влаштований Knowledge Graph: базові концепції
Перш ніж переходити до архітектури впровадження, варто зрозуміти три ключові поняття, без яких решта не складеться в цілісну картину.
Сутності, зв'язки, властивості
Граф знань складається з трьох елементів:
- Вузли (сутності) — це об'єкти реального світу: клієнт, постачальник, контракт, транзакція, співробітник, продукт. Кожен вузол має тип і набір властивостей.
- Ребра (зв'язки) — іменовані, типізовані з'єднання між вузлами. Не просто "A пов'язаний з B", а "Клієнт X підписав Контракт Y" або "Постачальник Z є дочірньою компанією Холдингу W". Тип зв'язку — це і є смисл.
- Властивості — атрибути вузлів і ребер: дата підписання, сума транзакції, статус відповідності, часова мітка останнього оновлення.
Реляційна база зберігає ті самі дані, але в плоских таблицях. Щоб дізнатися, чи є у постачальника спільний бенефіціар із санкційною структурою, аналітик пише складний SQL-запит з кількома JOIN-ами — і молиться, щоб усі таблиці мали спільний ключ. Граф проходить цей шлях природно: просто йде по ребрах.
Онтологія: словник вашого бізнесу
Онтологія — це формальний опис того, що означають сутності і зв'язки у вашому конкретному контексті. Що таке "активний клієнт" у вашій CRM? Чи збігається це визначення з тим, що розуміє під "активним клієнтом" ваша фінансова система? Якщо ні — граф масштабує цю суперечність.
Робота з онтологією — найскладніша і найдовговічніша частина будь-якого впровадження. Але саме вона перетворює граф із технічного проекту на стратегічний актив: добре визначена онтологія живе роками і стає спільною мовою між відділами, системами і AI-агентами.
Темпоральне версіонування
Бізнес-дані змінюються. Постачальник, що був чистим у понеділок, може потрапити під санкції у середу. Контракт, що діяв рік тому, міг мати інші умови. Темпоральне версіонування — це здатність графу зберігати стан зв'язків у часі і відповідати на питання "яким був стан цієї мережі на конкретну дату?". Для комплаєнсу, аудиту і регуляторної звітності це не опція — це вимога.
GraphRAG: як граф і LLM працюють разом
GraphRAG — це архітектурний патерн, що поєднує графовий пошук із векторним у гібридній системі. Розберемо, що відбувається під капотом, коли користувач ставить запит.
Крок 1: Розбір запиту. LLM аналізує питання і визначає, які сутності і зв'язки релевантні. "Які наші постачальники першого рівня мають ризик затримки поставок цього кварталу?" — модель розпізнає сутності (постачальники, поставки, квартал) і тип зв'язку (ризик затримки).
Крок 2: Гібридний пошук. Система одночасно запускає два пошуки:
- Векторний — знаходить семантично схожі документи і фрагменти (звіти, листування, оцінки постачальників).
- Графовий — проходить по ребрах графу і витягує структурований підграф: постачальник → контракти → терміни поставок → попередні затримки → фінансовий стан → залежні замовлення.
Крок 3: Злиття контексту. Обидва результати об'єднуються в структурований контекст, що передається LLM. Модель бачить не просто "схожі документи", а перевірену мережу фактів з явними зв'язками.
Крок 4: Генерація відповіді з джерелами. LLM формує відповідь, спираючись на конкретні вузли і ребра графу. Кожне твердження у відповіді прив'язане до джерела — не до "документа №47", а до конкретного зв'язку між конкретними сутностями.
Граф не обмежує модель — він дає їй те, чого їй бракує: перевірену карту реальності, якою вона може довіряти.
Саме тому GraphRAG-розгортання стабільно перевершують стандартний RAG за точністю і пояснюваністю в корпоративних середовищах. Microsoft, що відкрила першу широко прийняту реалізацію GraphRAG у 2024 році, задокументувала суттєве скорочення кількості токенів і підвищення точності на складних багатокрокових запитах порівняно зі звичайним векторним пошуком.
Що GraphRAG реально змінює в операційній роботі
Операційний зсув найпомітніший у трьох сферах:
Закупівлі та управління постачальниками. Замість того щоб людина вручну звіряла нового постачальника з базами відповідності, санкційними списками і даними про виконання попередніх контрактів — граф-агент проходить усі ці зв'язки за секунди і видає структуровану рекомендацію з повним журналом дій.
Комплаєнс і регуляторна звітність. Регуляторні запити, на які раніше команда аналітиків витрачала дні, витягуючи дані з п'яти систем, тепер закриваються одним графовим запитом — з повним ланцюжком джерел, що показує, які саме дані лягли в основу відповіді.
Підтримка рішень на рівні керівництва. Коли CFO запитує, які корпоративні клієнти ризикують відтекти, відповідь вимагає узгодити, що означає "активний клієнт" у п'яти різних системах. Платформа на основі графу знань автоматизує саме це узгодження.
Один задокументований кейс — глобальний інвестиційний банк, що об'єднав транзакційні системи, профілі клієнтів, бази контрагентів і санкційні списки в єдиний граф — скоротив частку хибних спрацьовувань у AML-алертах на 40% порівняно з правиловими системами, а ручне навантаження на кожного комплаєнс-аналітика зменшилось приблизно на 35 годин на тиждень. Граф моделював сутності й зв'язки з темпоральним версіонуванням, тому кожен запит відображав поточний стан постійно змінюваної мережі.
Як будувати архітектуру: що насправді потрібно
Ринок платформ для графів знань суттєво дозрів. За прогнозом MarketsandMarkets, сегмент зросте з приблизно $1,9 млрд у 2026 році до $9,88 млрд до 2032-го — річний темп зростання 31,6%, який рухають виробничі впровадження, а не пілоти. За галузевою статистикою OvalEdge, від 65% до 78% великих підприємств вже використовують або тестують графи знань, а головними бар'єрами залишаються дата-силоси і складність інтеграції.
Для компаній середнього ринку є хороша новина: будувати з нуля не обов'язково. Платформи на кшталт Neo4j, TigerGraph і Stardog забезпечують інфраструктуру графових баз даних, а патерни інтеграції за останні два роки стали значно менш інвазивними.
У жовтні 2025 року Neo4j оголосив про інвестицію $100 млн у GenAI і запустив Neo4j Aura Agent у режимі раннього доступу — платформу, що дозволяє будувати, тестувати і розгортати AI-агентів безпосередньо з корпоративних даних у AuraDB за лічені хвилини, з наскрізною автоматизованою оркестрацією для графового пошуку знань. Загальна доступність платформи відбулась у лютому 2026 року. Це суттєвий зсув: граф більше не просто сховище даних — він стає хребтом міркування для автономних агентів. Як зазначив Чарльз Бетц, VP Principal Analyst у Forrester: "Граф є необхідним. Він — скелет для плоті LLM."
Послідовність впровадження, що знижує ризики
Компанії, що успішно впроваджують Knowledge Graph AI, зазвичай дотримуються одного й того самого патерну.
Почніть з маякового кейсу. Оберіть одне питання з високою цінністю, яке бізнес ставить постійно, але відповідає повільно — оцінка ризику постачальника, прогноз відтоку клієнтів, виявлення прогалин у комплаєнсі. Сфокусоване початкове впровадження зазвичай дає вимірювані результати за 60–90 днів.
Змоделюйте ключові сутності й зв'язки. Визначте, що означають "клієнт", "постачальник", "контракт" і "транзакція" у ваших системах — не просто як поля бази даних, а як семантичні концепції з явними зв'язками. Ця робота з онтологією — найскладніша частина і найдовговічніша інвестиція.
Інтегруйте без зламу існуючого. Найкращі впровадження не вимагають заміни наявних систем. Вони віртуалізують або федерують дані з існуючих джерел у граф-шар, зберігаючи поточні процеси і додаючи поверх них шар зв'язного мислення.
AI-шар — останній. Коли граф заземлений і керований, підключення LLM через GraphRAG стає простим кроком. Точність моделі прямо залежить від якості графу — саме тому будувати граф першим не опція, а необхідність.
Governance — з першого дня. Права доступу, журнали аудиту і виконання політик мають бути вбудовані в семантичний шар до того, як AI-агенти почнуть давати рекомендації. Саме це відрізняє виробниче розгортання від демо. Чому governance не можна додати заднім числом — детально розібрано у статті про побудову AI-governance фреймворку.
AI-агент, що за мілісекунди проходить весь бізнес-граф, настільки надійний, наскільки надійний governance-шар, що контролює, що він може бачити і робити.
Структурне вирішення проблеми галюцинацій
SAP реалізував GraphRAG, заземлюючи запити LLM у метадані бізнес-процесів, моделі даних і документацію. Результат — AI-асистент, що отримує перевірені актуальні відповіді, а не генерує правдоподібно звучні. Коли внутрішній інструмент запитують про політику ескалації для клієнта першого рівня, граф надає точку запиту: асистент звертається до графу, отримує структурований підграф релевантних сутностей і зв'язків, і використовує його як фактичну основу для відповіді.
Це архітектурна відповідь на проблему галюцинацій — не кращий промпт, не більше обмежень, а структурований шар знань, до якого модель зобов'язана звертатися перед будь-якою відповіддю. Для керівників, що оцінюють AI-ризики, ця різниця принципова. Що відбувається, коли такий шар заземлення відсутній, — розібрано в аналізі ризиків галюцинацій AI у критичних рішеннях.
Бізнес-кейс: що змінюється, коли граф запущено
Компанії, що розгортають корпоративні графи знань, повідомляють про ROI до 320% і втричі швидші цикли розробки аналітики — за даними Motadata. Ці цифри відображають ефект накопичення: граф не просто відповідає на одне питання швидше, він змінює структуру витрат на кожне питання, що залежить від пов'язаних даних.
Для CEO або COO операційний переклад конкретний:
- Цикли погодження, що раніше вимагали координації між відділами, стають автоматизованими процесами з верифікованими графом вхідними даними.
- Рішення щодо закупівель, на які йшли дні ручного звірення, приймаються за хвилини — з повним журналом аудиту.
- Регуляторна звітність, що вимагала команд аналітиків із кількох систем, перетворюється на запланований графовий запит з автоматичною документацією.
- Дашборди керівництва перестають показувати запізнілі індикатори, зібрані вручну, і починають відображати реальний стан бізнесу в реальному часі.
Є й емоційний зсув, що приходить разом із цим, — і його варто назвати прямо. Ви перестаєте управляти від кризи до кризи, реагуючи на те, що спливло цього тижня. Натомість приходить відчуття справжнього контролю: бізнес стає читабельним, рішення відчуваються обґрунтованими — бо вони справді обґрунтовані перевіреними даними, а не тим, хто випадково був на останній нараді. Це не метафора. Керівники, що пройшли через таке впровадження, описують це як перехід від постійної тривоги "а що ми пропустили?" до спокійної впевненості "ми бачимо все, що важливо".
Важлива і зміна сприйняття ззовні. Коли рада директорів або інвестор запитує, як компанія управляє ризиком постачальників, як приймаються комплаєнс-рішення або яка експозиція до конкретного контрагента — відповідь більше не "у нас є процес", а "ось результат графового запиту з повним ланцюжком джерел". Це різниця між компанією, що говорить про рішення на основі даних, і тією, що може продемонструвати їх на вимогу. Саме така операційна прозорість змінює сприйняття керівництва — не лише всередині, а й серед тих, чия довіра визначає вартість капіталу компанії.
Для компаній, що оцінюють ROI AI-інфраструктури ширше, у статті про AI ROI: як довести цінність бізнесу є структурована методологія для побудови внутрішнього бізнес-кейсу.
Часті запитання
Що таке Knowledge Graph AI простими словами? Це система, що моделює бізнес-дані як мережу пов'язаних сутностей — клієнтів, постачальників, контрактів, транзакцій, співробітників — і робить ці зв'язки доступними для запитів як людей, так і AI-систем. Коли LLM підключений до такого графу, він міркує на основі перевірених зв'язків, а не генерує відповіді лише зі статистичних патернів.
Чим граф знань відрізняється від звичайної бази даних або векторної бази? Реляційна база зберігає ізольовані записи в таблицях; векторна база знаходить семантично схожий контент. Граф знань зберігає явні зв'язки між сутностями і робить їх прохідними. Він може відповісти на питання "хто з наших постачальників має спільну материнську компанію із санкційною структурою?" — а це запит, що вимагає проходу по мережі, а не зіставлення рядків чи пошуку схожого тексту.
Що таке GraphRAG і чому це важливо для бізнесу? GraphRAG поєднує графовий пошук із векторним у гібридній архітектурі. Векторний компонент знаходить семантично релевантний контент; графовий додає бізнес-структуру, шляхи зв'язків і поточний операційний контекст. Разом вони дають LLM заземлені, точні вхідні дані — саме тому GraphRAG-розгортання стабільно перевершують стандартний RAG за точністю і пояснюваністю в корпоративних середовищах.
Скільки часу займає розгортання графу знань у реальному бізнесі? Сфокусований початковий кейс зазвичай дає результати за 60–90 днів. Повне виробниче розгортання з governance, моніторингом і AI-інтеграцією займає від трьох до шести місяців. Розширення на весь бізнес — це тривала програма: граф росте в міру підключення нових джерел даних і нових кейсів.
Які найбільші ризики і типові провали? Найпоширеніша помилка — ставитися до графу як до технологічного проекту, а не до проекту з управління даними. Якщо базові дані погано підтримуються або онтологія визначена непослідовно, граф масштабує ці проблеми. Друга за частотою помилка — пропустити governance: розгортання AI-агентів поверх графу без контролю доступу і журналів аудиту створює комплаєнс-ризики, а не ефективність.
Чи потрібен граф знань меншим компаніям, чи це тільки для великих підприємств? Архітектура масштабується вниз. Компанії середнього ринку з 200–2 000 співробітників часто мають ту саму проблему дата-силосів, що й великі підприємства — просто менше ресурсів для її ручного вирішення. Хмарні платформи суттєво знизили інфраструктурні витрати, а добре сфокусоване початкове впровадження можна побудувати і перевірити без бюджету корпоративного масштабу.
Компанії, що визначатимуть свої галузі наступні п'ять років, — не ті, у кого найбільше даних. А ті, чиї дані пов'язані, керовані і доступні для запитів AI-систем, що міркують, а не вгадують. Граф знань — це не функція, яку додають до AI-стеку. Це фундамент, що визначає, чи достатньо надійний ваш AI-стек для критичних рішень без людини на кожному кроці.
Побудуйте граф — і інтелект прийде сам. Пропустіть його — і ви просто автоматизуєте хаос.
Є питання? Запитайте AI-агента прямо зараз
Відповідає за секунди, знає все про наші послуги та допоможе розібратися у вашій ситуації
Читайте також
AI-агенти vs CAPTCHA: що робити бізнесу
AI-агенти щодня натикаються на CAPTCHA — і це коштує бізнесу реальних грошей. Розбираємо причини, наслідки та практичні рішення для автоматизації.
АвтоматизаціяAI-агент для закупівель за моделлю Google DeepMind
Архітектура мультиагентної системи Google DeepMind Co-Scientist — і як вона точно відображає логіку корпоративних закупівель. Практичний план побудови.
АвтоматизаціяGoogle дав видавцям зброю — читайте дрібний шрифт
Google запустив кнопку Preferred Sources для видавців. Що вона реально дає, чого не дає — і яка стратегія захищає контент-бізнес в епоху AI-пошуку.