
Qwen3Guard: безпека AI у реальному часі
Qwen3Guard-Stream модерує відповіді LLM на рівні токенів під час генерації — не після. Архітектура, розміри моделей і бізнес-наслідки для B2B-продуктів.
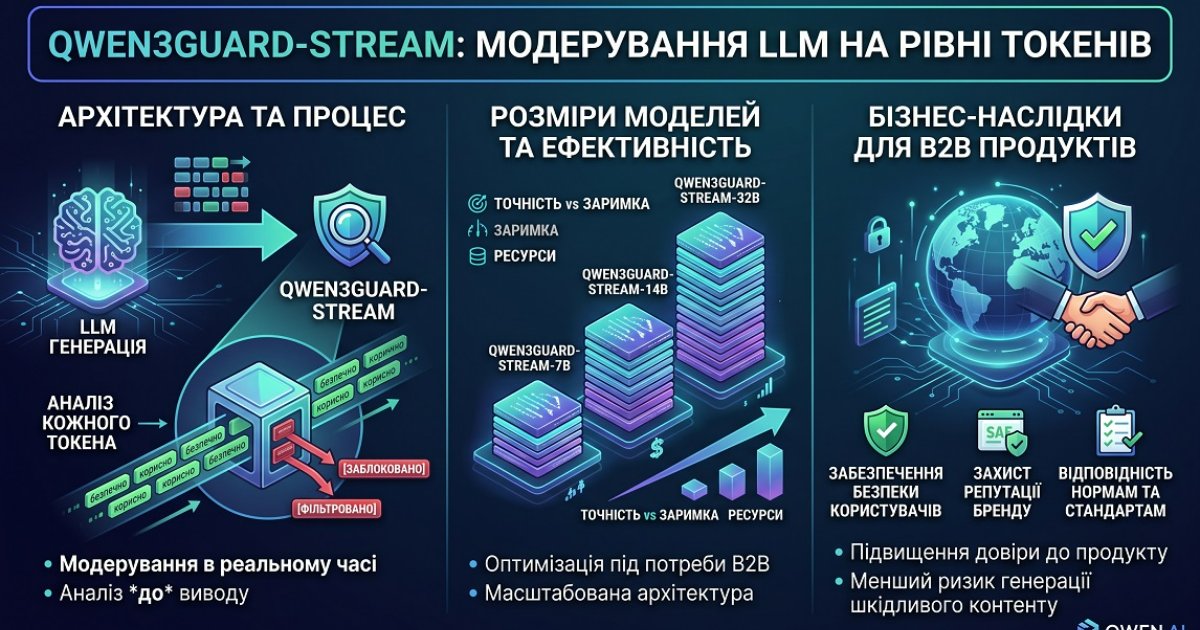
Коли модель вже відповідає, а ви ще не встигли її зупинити
Користувач надсилає запит до вашого AI-асистента о 2:47 ночі. LLM починає стримити відповідь — токен за токеном, речення за реченням — ще до того, як будь-який шар модерації побачив повний вивід. Коли пост-генераційний класифікатор нарешті позначає відповідь як шкідливу, кілька сотень токенів небезпечного контенту вже на екрані клієнта. Черговий інженер отримує сповіщення в Slack. Репутаційна й юридична шкода вже запущена.
Це не гіпотетичний крайній випадок — це архітектурна прогалина, на яку рано чи пізно натикається кожна SaaS-команда, що виводить LLM-функції у продакшн. Зараз на неї є конкретна технічна відповідь, і вона змінює економіку побудови безпечних AI-продуктів значно глибше, ніж просто заміна одного API модерації на інший. Деталі варті уважного читання.
Архітектурна проблема, про яку мало говорять
Більшість систем захисту працюють однаково: чекають, поки модель закінчить генерацію, а потім пропускають готову відповідь через класифікатор. Концептуально чисто, легко прикрутити до наявного пайплайну. І водночас — принципово зламано для стримінгових деплойментів.
Коли продукт стримить токени напряму до користувачів — а це стандартний UX для будь-якого чат-інтерфейсу, що хоче відчуватися живим — пост-генераційний класифікатор не є захистом. Це розтин після смерті. Шкідливий контент уже доставлено. Класифікатор просто пише звіт про інцидент.
Проміжок між «модель починає генерувати» і «модерація спрацьовує» — це і є ваша зона ризику.
Альтернатива — запускати повну перевірку безпеки на кожному проміжному токені — звучить дорого, бо історично так і було. Окремий інференс-виклик на кожен токен множить затримку й витрати на GPU на порядок. Тому більшість команд йшла на прагматичний компроміс: перевіряти вхідний промпт, пропускати токен-рівневу модерацію виводу і сподіватися, що модель поводиться пристойно.
Команда Qwen від Alibaba опублікувала технічне рішення, яке робить цей компроміс непотрібним.
Що таке Qwen3Guard насправді
Qwen3Guard — це серія відкритих моделей модерації безпеки, побудованих на архітектурі Qwen3 і навчених на датасеті з 1,19 мільйона промптів і відповідей з мітками безпеки. Серія виходить у двох архітектурно різних варіантах і трьох розмірах — 0,6B, 4B і 8B параметрів — від edge-деплойментів до повноцінних продакшн-кластерів.
Qwen3Guard-Gen працює як генеративний класифікатор: приймає повний промпт і повну відповідь моделі, а потім видає структурований вердикт безпеки. Цей варіант призначений для офлайн-анотації датасетів, сигналів безпеки у RL-пайплайнах і будь-яких сценаріїв, де затримка не є головним обмеженням.
Qwen3Guard-Stream — архітектурно новіша частина. Замість того щоб чекати на повну відповідь, він приєднує дві легкі класифікаційні голівки до фінального шару трансформера. Це дозволяє отримувати вивід LLM токен за токеном — у процесі генерації — і видавати класифікацію безпеки на кожному кроці. Модерація йде паралельно з генерацією, а не після неї.
Обидва варіанти підтримують 119 мов і діалектів — важливо для будь-якого продукту з глобальною аудиторією. Всі моделі виходять під ліцензією Apache 2.0, тобто комерційне використання нічим не обмежене.
Трирівнева система серйозності
Більшість наявних моделей захисту видають бінарний вивід: безпечно або небезпечно. Це породжує добре відому проблему — різні датасети використовують різні стандарти анотації, тому модель, навчена на одному стандарті, систематично помиляється при оцінці за іншим. Результат — або надмірне блокування (відхилення легітимних запитів), або недостатнє (пропуск шкідливих), залежно від того, в який бік зміщена калібрування.
Qwen3Guard вводить третю категорію: Суперечливо. Контент класифікується як Небезпечний (шкідливий у більшості контекстів), Суперечливий (залежить від контексту, може бути прийнятним в окремих деплойментах) або Безпечний. Ця трикласова схема дозволяє операторам налаштовувати систему під власний поріг ризику, а не приймати єдиний стандарт для всіх.
На практиці це означає: медична інформаційна платформа може обробляти суперечливий контент про взаємодію ліків інакше, ніж загальний споживчий чатбот. Логіка класифікації однакова — дія після неї налаштовується під кожен деплоймент.
Дев'ять категорій шкоди охоплюють: насильницький контент, ненасильницькі незаконні дії, сексуальний контент, розкриття персональних даних, суїцид і самоушкодження, неетичні дії, політично чутливі теми, порушення авторських прав і спроби джейлбрейку. Ця таксономія безпосередньо відповідає вимогам відповідності, з якими вже працює більшість регульованих галузей.
Як стримінговий пайплайн працює на практиці
Операційний потік Qwen3Guard-Stream складається з двох паралельних треків, що йдуть одночасно:
Перевірка на рівні промпту: коли користувач надсилає запит, він одночасно потрапляє і до LLM, і до Qwen3Guard-Stream. Модель-охоронець негайно оцінює безпеку промпту і присвоює мітку серйозності. Оркестраційний шар вирішує — дозволити розмову продовжити чи зупинити її до того, як LLM згенерує хоч один токен.
Модерація на рівні токенів: якщо розмова продовжується, LLM починає стримити відповідь. Кожен згенерований токен у реальному часі передається до Qwen3Guard-Stream. Охоронець оцінює безпеку на кожному кроці — це дозволяє перервати генерацію посередині, щойно виявлено небезпечну траєкторію, а не після того, як повна відповідь доставлена.
Ось у чому архітектурний зсув. Система не чекає межі речення, абзацу чи завершеної відповіді. Вона може втрутитися на рівні токена — а значить, максимальне вікно експозиції шкідливого контенту вимірюється токенами, а не відповідями.
Варіанти деплойменту і вибір розміру
Три розміри моделей відображають різні обмеження деплойменту:
- 0,6B — підходить для edge-деплойментів, ресурсно обмежених середовищ або сценаріїв, де легкий фільтр на CPU є прийнятним. Технічний звіт зазначає, що навіть варіант 0,6B перевершує більші конкуруючі моделі на кількох англомовних бенчмарках.
- 4B — практичний вибір для більшості продакшн-стримінгових пайплайнів. Достатньо малий, щоб розмістити разом із роутинг-проксі на одному GPU-вузлі, і достатньо великий для надійної нюансованої класифікації.
- 8B — максимальна точність, підходить для деплойментів з високими ставками, де хибно-негативні результати несуть значні юридичні або репутаційні наслідки.
Моделі доступні на Hugging Face і ModelScope. Для команд, які надають перевагу керованому шляху, Alibaba Cloud пропонує сервіс AI Guardrails на базі технології Qwen3Guard — без необхідності керувати інфраструктурою самостійно.
Стек обслуговування стандартний: Qwen3Guard-Gen працює з vLLM, SGLang або будь-яким сумісним інференс-фреймворком. Потрібна версія бібліотеки transformers 4.51.0 або вища.
Мінімальний патерн інтеграції
Для команди, що запускає стримінговий чат-API, патерн інтеграції Qwen3Guard-Stream виглядає приблизно так:
# Псевдокод — ілюстративний патерн, не готовий до продакшну
from transformers import AutoTokenizer, AutoModelForSequenceClassification

guard = AutoModelForSequenceClassification.from_pretrained("Qwen/Qwen3Guard-Stream-4B")
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3Guard-Stream-4B")

def stream_with_guard(user_prompt, llm_stream):
    # Крок 1: перевірка промпту до початку генерації
    prompt_label = guard.classify_prompt(user_prompt)
    if prompt_label == "unsafe":
        yield "[Запит заблоковано політикою безпеки]"
        return

    # Крок 2: токен-рівнева модерація під час генерації
    buffer = []
    for token in llm_stream:
        buffer.append(token)
        label = guard.classify_token_stream(buffer)
        if label == "unsafe":
            yield "[Відповідь перервано політикою безпеки]"
            return
        yield token
Ключовий архітектурний момент: модель-охоронець працює як sidecar-процес поруч із LLM, а не як послідовний крок постобробки. Це мінімізує накладні витрати на затримку — класифікаційні голівки, прикріплені до фінального шару трансформера, легкі за задумом.
Розміщення 4B-моделі охоронця разом із LLM на одному інференс-вузлі — не теоретична оптимізація, а передбачений патерн деплойменту, який повністю змінює розрахунок витрат.
Що це означає для бізнесу, що випускає LLM-функції
Технічна архітектура цікава. Бізнес-наслідки — терміновіші.
Будь-яка компанія, що вбудовує LLM-можливості в клієнтський продукт, несе неявну відповідальність за те, що ця модель виводить. Це не гіпотетична юридична позиція — саме в цьому напрямку рухаються регуляторні рамки в кількох юрисдикціях, і це вже практична реальність для компаній у сферах охорони здоров'я, фінансових послуг, юридичних технологій та освіти. Питання не в тому, чи потрібна вам модерація контенту. Питання в тому, чи ваш поточний підхід справді працює на рівні токенів — чи лише виглядає так.
Для CTO або VP of Engineering Qwen3Guard-Stream закриває конкретний архітектурний борг: прогалину між стримінговим UX і безпекою в реальному часі. Більше не потрібно вибирати між чуйним продуктом і безпечним. Модель 4B достатньо мала, щоб працювати на тій самій інфраструктурі, за яку ви вже платите, ліцензія Apache 2.0 знімає будь-які обмеження на комерційне використання, а підтримка 119 мов означає, що один деплоймент обслуговує глобальну аудиторію без управління окремими моделями для кожної мови.
Для CEO або COO рамка інша. Кожен інцидент, коли ваш AI-продукт видає шкідливий контент — це ескалація до служби підтримки, потенційний регуляторний запит і історія, яка може розійтися в соцмережах ще до того, як ваша команда закінчить писати звіт про інцидент. Qwen3Guard-Stream не усуває цей ризик повністю — жодна система не усуває — але переносить точку втручання з «після доставки» на «під час генерації», а це єдине місце, де запобігання взагалі можливе.
Керівники, які роблять це правильно — будують AI-продукти з інфраструктурою безпеки в реальному часі, а не з модерацією заднім числом — саме на них будуть посилатися ради директорів і інвестори, коли наступний галузевий інцидент потрапить у заголовки. Не тому, що вони уникли всіх ризиків, а тому, що побудували системи, які демонструють: вони розуміли ризик і свідомо проектували навколо нього. Ось як виглядає «відповідальне розгортання AI» на практиці, а не в прес-релізі.
І на більш безпосередньому рівні: є справжнє полегшення в тому, що ваша продакшн-система не знаходиться на відстані одного ворожого промпту від кризи. Цей спокій — здатність випускати LLM-функції без фонової тривоги про те, що модель скаже о третій ночі — сам по собі є бізнес-активом. Він звільняє увагу інженерів для роботи над продуктом замість реагування на інциденти.
Для команд, що вже думають про ширший шар управління навколо AI-агентів, варто прочитати аналіз інциденту OpenAI Wiki і що він розкрив про фреймворки AI-governance. А якщо prompt injection входить до вашої моделі загроз — а для будь-якого LLM-продукту з зовнішнім доступом так і має бути — аналіз ризиків prompt injection у контексті фінансових даних охоплює поверхню атаки, яку модерація контенту сама по собі не закриває.
Перевага відкритого коду в інфраструктурі безпеки
Є структурний аргумент на користь відкритих моделей захисту, що виходить за межі вартості. Коли ваш шар безпеки — це сторонній API, у вас обмежена видимість того, що саме він класифікує і чому. Ви не можете перевірити навчальні дані, не можете скоригувати пороги класифікації і залежите від аптайму та цінових рішень вендора.
Випуск Qwen3Guard під Apache 2.0 означає: ви можете перевірити модель, дотренувати її на специфічному для вашої галузі контенті за потреби, запустити повністю у власній інфраструктурі і зберігати повні журнали аудиту кожного рішення з модерації. Для компаній, що працюють під вимогами щодо резидентності даних або обробляють чутливі дані користувачів, це не приємний бонус — це вимога відповідності, яку хмарні API модерації структурно не можуть виконати.
Методологія навчання також заслуговує на увагу. 1,19 мільйона розмічених прикладів оброблялися за схемою подвійного режиму навчання (суворий/м'який), яка явно позначає розбіжності як Суперечливі, а не примусово зводить їх до бінарної мітки. Саме так трирівнева система досягає стійкості між датасетами з різними стандартами анотації — проблема, яка історично змушувала бінарні класифікатори нестабільно працювати в різних контекстах деплойменту.
Якщо ви порівнюєте Qwen3Guard з альтернативами на кшталт сімейства Llama Guard від Meta, ключова відмінність — стримінгова архітектура. Моделі Llama Guard працюють із повними вводами і виводами; Qwen3Guard-Stream спеціально спроектований для токен-рівневого втручання в реальному часі. Це різні інструменти, що вирішують різні проблеми, і для стримінгових деплойментів лише один із них справді закриває основну архітектурну прогалину.
Для команд, що думають про ширший ландшафт відкритих моделей і чому великі AI-лабораторії вкладають у них мільярди, аналіз того, чому Big Tech платить мільярди за відкриті моделі дає корисний стратегічний контекст.
FAQ
Чи підходить Qwen3Guard-Stream для продакшн-використання, чи це переважно дослідницький реліз? Варіант 4B явно спроектований для продакшн-стримінгових пайплайнів і достатньо малий, щоб розмістити разом із роутинг-проксі на одному GPU-вузлі. Ліцензія Apache 2.0 і доступність на стандартних фреймворках обслуговування (vLLM, SGLang) підтверджують: це продакшн-реліз, а не дослідницький прототип. Alibaba Cloud також пропонує керовану версію для команд, які не хочуть самостійно обслуговувати інфраструктуру.
Як трирівнева класифікація (Безпечно / Суперечливо / Небезпечно) працює на практиці? Оператори налаштовують дії після кожного рівня. Небезпечний контент викликає негайне переривання; суперечливий контент можна направити на вторинний крок перевірки, записати для перегляду людиною або обробити як небезпечний — залежно від порогу ризику деплойменту. Ця гнучкість дозволяє одній і тій самій моделі обслуговувати і консервативний корпоративний кейс відповідності, і більш ліберальну творчу платформу без перенавчання.
Які дев'ять категорій шкоди охоплює Qwen3Guard? Поточна таксономія включає: насильницький контент, ненасильницькі незаконні дії, сексуальний контент, розкриття персональних даних, суїцид і самоушкодження, неетичні дії, політично чутливі теми, порушення авторських прав і спроби джейлбрейку. Ці категорії тісно відповідають таксономіям шкоди, що використовуються в основних регуляторних рамках і стандартах контентної політики.
Чи можна дотренувати Qwen3Guard на специфічних для галузі даних? Так. Ліцензія Apache 2.0 дозволяє дотренування, а архітектура моделі — стандартна трансформерна, сумісна зі звичайними інструментами дотренування. Команди зі специфічними для галузі контентними політиками — медичними, юридичними, фінансовими — можуть адаптувати межі класифікації під власні стандарти, а не приймати стандартний розподіл навчання.
Які мови підтримує Qwen3Guard? 119 мов і діалектів, з багатомовним навчанням, що включає перекладений контент, перевірений через виявлення змішування мов. Продуктивність оцінюється на багатомовних бенчмарках, включаючи RTP-LX, що робить його однією з найбільш ретельно перевірених багатомовних моделей захисту.
Як Qwen3Guard-Stream справляється з накладними витратами на затримку при класифікації кожного токена? Класифікаційні голівки — це легкі доповнення до фінального шару трансформера, а не окремі інференс-виклики моделі. Це означає, що накладні витрати на токен значно нижчі, ніж при запуску повного інференсу моделі для кожного токена. Дизайн спеціально спроектований для стримінгових сценаріїв з низькою затримкою, а розмір 4B підібраний так, щоб зробити спільний деплоймент на наявній інференс-інфраструктурі практичним.
Питання, яке варто поставити собі, — чи потребує ваш поточний LLM-продукт модерації контенту в реальному часі? Майже напевно потребує. Питання в тому, чи ваша поточна архітектура справді її забезпечує — чи лише створює таке враження, залишаючи реальне вікно експозиції відкритим. Qwen3Guard-Stream — це конкретна, розгортувана відповідь на конкретну архітектурну проблему. Чи підходить він вашому стеку — залежить від вашої інфраструктури обслуговування, вимог відповідності та того, яку частину шару модерації ви хочете тримати у себе, а яку — віддати на аутсорс. Але проблема, яку він вирішує, реальна, рішення безкоштовне у використанні, а прогалина, яку він закриває, структурно недосяжна для пост-генераційних класифікаторів. Це корисна комбінація.
Є питання? Запитайте AI-агента прямо зараз
Відповідає за секунди, знає все про наші послуги та допоможе розібратися у вашій ситуації
Читайте також
Google DiffusionGemma: AI без навчання з нуля
DiffusionGemma від Google DeepMind змінює правила: fine-tuning замість дорогого навчання, Apache 2.0, 1000+ токенів/с і локальний деплой без хмарних API.
Технічні гайдиВаші корпоративні дані в Claude потрапили до Google
Shared chats і Artifacts Claude виявились індексованими Google. Розбираємо, які бізнес-дані витікають через AI та як закрити ці прогалини.
Технічні гайдиClaude Opus 5 змінив правила роботи з AI-агентами
Claude Opus 5 вийшов 24 липня 2026 року й зламав стару логіку побудови агентів. Практичний чеклист для команд, що вже використовують Claude у продакшні.