
Vals & a16z: як AI-бенчмарки вирішують все
Vals і a16z змінюють правила оцінки AI-агентів: чому бенчмарки тепер визначають, кого обирає бізнес і скільки коштує помилка вибору.
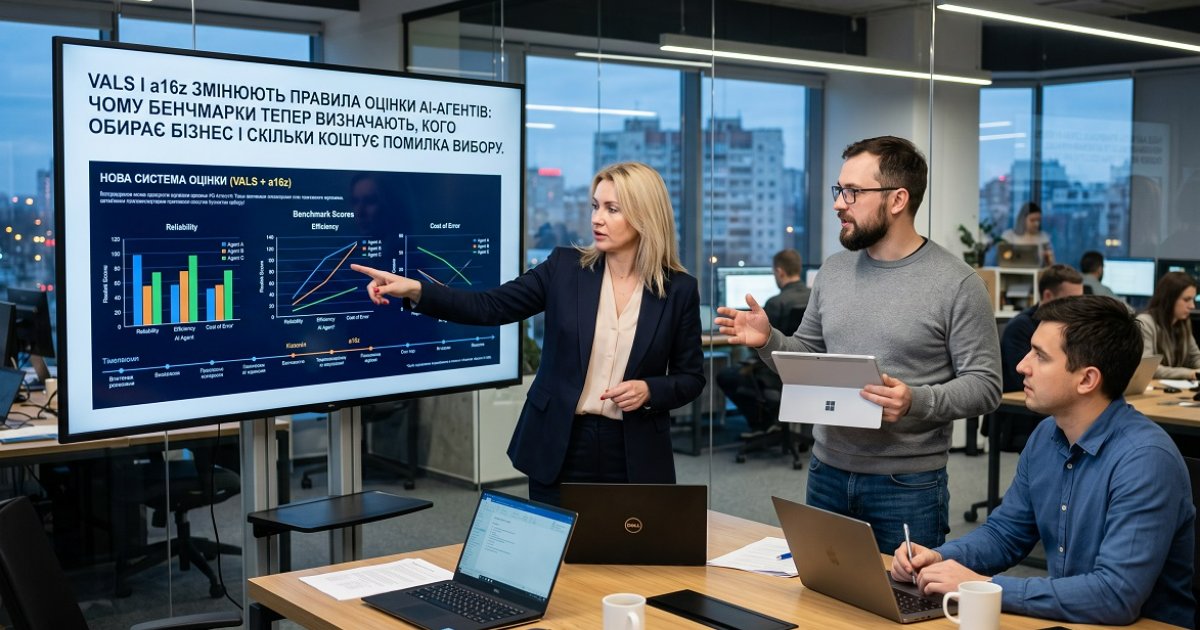
Ринок AI-агентів переповнений обіцянками. Кожен вендор запевняє, що його модель — найточніша, найшвидша, найнадійніша. Але як перевірити ці слова до того, як підписати контракт? Саме тут з'являється нова гравець — Vals AI — і разом із венчурним гігантом a16z вона переписує логіку того, як підприємства обирають AI-рішення.
Чому бенчмарки раптом стали вирішальними
Ще рік тому бенчмарки були академічною розвагою. Тепер вони — перший рядок у тендерній документації. Компанії більше не купують "AI взагалі": вони купують конкретну продуктивність на конкретних задачах.
Vals і a16z зробили ставку на те, що стандартизована оцінка стане інфраструктурою ринку — так само, як аудит став інфраструктурою фінансів. І схоже, ставка виграє.
Раніше вибір AI-платформи нагадував купівлю кота в мішку. Демо виглядало бездоганно, пілот проходив гладко, а потім у продакшені модель починала галюцинувати на крайових кейсах саме тоді, коли це найбільш боляче. Проблема не в тому, що моделі погані — проблема в тому, що їх порівнювали неправильно.
Стандартні публічні бенчмарки на кшталт MMLU чи HumanEval вимірюють загальні здібності. Але підприємство не наймає "загальний інтелект" — воно наймає агента, який має витягувати дані з контрактів, класифікувати заявки клієнтів або генерувати фінансові звіти. Різниця між "добре на бенчмарку" і "добре на моїй задачі" може коштувати мільйони.
Що робить Vals AI і навіщо це a16z
Vals AI будує платформу для domain-specific оцінки моделей. Не абстрактні тести — а сценарії, що відтворюють реальні робочі процеси конкретних індустрій: юридичні документи, медичні записи, фінансова аналітика. Компанія дає підприємствам інструмент, щоб самостійно перевірити, яка модель краще справляється саме з їхніми даними і задачами.
a16z зайшов у цю гру не випадково. Фонд давно ставить на те, що AI-інфраструктура — це наступний великий шар вартості після самих моделей. Якщо моделі стають товаром (а вони стають), то виграє той, хто контролює стандарти оцінки, довіру і вибір. Vals претендує саме на цю позицію.
Контроль над бенчмарком — це контроль над наративом. Хто встановлює стандарт вимірювання, той і визначає, хто "виграє" на ринку.
Це не конспірологія — це базова ринкова логіка. Подивіться на те, як рейтингові агентства формують ринок облігацій, або як сертифікація ISO визначає постачальників у промисловості. Vals і a16z хочуть зайняти аналогічну роль в AI-закупівлях.
Як це змінює логіку enterprise-закупівель
Раніше процес вибору AI-вендора виглядав так: маркетингові матеріали → демо → невеликий пілот → рішення на основі "відчуття". Тепер з'являється новий крок — і він стає центральним.
Компанії, що вже використовують підхід Vals, описують процес інакше:
- Визначають конкретні задачі, які має виконувати агент
- Збирають або генерують репрезентативний набір тестових кейсів зі своїх реальних даних
- Запускають кілька моделей паралельно на цих кейсах
- Отримують кількісне порівняння — не "відчуття", а цифри
Результат: рішення про закупівлю спирається на дані, а не на переконливість сейлза. Для великих підприємств це принципово — особливо коли йдеться про безпеку AI-агентів і відповідальність за помилки.
Що це означає для вендорів
Для постачальників моделей нова реальність — це і можливість, і загроза одночасно. Якщо ваша модель справді краща на конкретних задачах, стандартизований бенчмарк це доведе — і продасть краще за будь-який маркетинг. Але якщо ваша модель виглядала добре лише завдяки вдалому демо, об'єктивне тестування це теж покаже.
Вендори вже реагують. Деякі активно співпрацюють із Vals, надаючи доступ до моделей для незалежного тестування. Інші — опираються, побоюючись прозорості. Сам факт цього опору говорить більше, ніж будь-який прес-реліз.
Що це означає для покупців
Для підприємств, що обирають AI-рішення, з'являється новий обов'язок — і нова можливість. Обов'язок: більше не можна виправдовувати поганий вибір відсутністю інструментів оцінки. Можливість: вперше є шанс купувати AI так само раціонально, як купують будь-яке інше програмне забезпечення.
Це особливо важливо в контексті ризиків vendor lock-out: якщо ви можете об'єктивно виміряти продуктивність, ви можете і перейти до іншого вендора, коли з'явиться краща альтернатива.
Де бенчмарки не вирішують усього
Чесність вимагає визнати: навіть найкращий бенчмарк — це не срібна куля. Є речі, які він не вловлює.
Латентність у продакшені відрізняється від латентності в тесті. Вартість API-викликів при масштабуванні може перекреслити перевагу в точності. Інтеграційна складність — скільки коштує підключити модель до вашого стеку — взагалі поза межами будь-якого бенчмарку.
І є ще одна тонкість: бенчмарк вимірює те, що ви вирішили виміряти. Якщо ваш тестовий набір не репрезентує реальний розподіл задач — результати будуть точними, але марними. Garbage in, garbage out — навіть у найсучаснішій оцінці.
Тому підхід Vals цінний не сам по собі, а в поєднанні з вбудованою оцінкою AI на рівні процесів — коли вимірювання стає частиною операційної культури, а не разовою перевіркою перед закупівлею.
Ширший контекст: стандартизація як зрілість ринку
Поява таких гравців, як Vals, — це сигнал зрілості. Ринки завжди проходять цей шлях: спочатку хаос і маркетингові обіцянки, потім стандарти і вимірювання, потім — справжня конкуренція на основі реальної продуктивності.
AI-ринок зараз десь між першим і другим етапом. Vals і a16z прискорюють перехід. І це добре для всіх, хто хоче купувати AI раціонально — і погано для тих, хто продає його на хайпі.
Паралельно варто стежити за тим, як розвивається governance AI-агентів: бенчмарки вирішують питання "що обрати", але governance вирішує питання "як безпечно використовувати". Обидва питання однаково важливі.
FAQ
Що таке Vals AI і чим вона відрізняється від стандартних бенчмарків? Vals AI — платформа для domain-specific оцінки AI-моделей. На відміну від загальних бенчмарків (MMLU, HumanEval), вона дозволяє тестувати моделі на реальних задачах конкретної індустрії — юридичних, медичних, фінансових — і отримувати порівняння, релевантне саме для вашого бізнесу.
Чому a16z інвестує в інфраструктуру оцінки, а не в самі моделі? Тому що моделі стають товаром. Коли десятки компаній пропонують порівнянні за якістю моделі, вартість зміщується до рівня вище — стандартів, довіри, інфраструктури вибору. Саме там a16z бачить довгострокову перевагу.
Чи можна довіряти бенчмаркам від третіх сторін? Частково. Незалежний бенчмарк краще, ніж маркетингові матеріали вендора. Але найнадійніший підхід — поєднувати зовнішні оцінки з власним тестуванням на ваших даних і задачах.
Як бенчмарки впливають на переговори з вендорами? Суттєво. Коли у вас є кількісні дані про продуктивність кількох моделей, ви переходите від позиції "нам сподобалось демо" до позиції "ваша модель показала X%, конкурент — Y%". Це принципово змінює баланс сил у переговорах.
Що робити, якщо у нас немає ресурсів для власного тестування? Починайте з малого: визначте 20-30 репрезентативних кейсів зі своїх реальних задач, запустіть їх на 2-3 моделях вручну. Навіть такий мінімальний тест дасть більше інформації, ніж будь-яке демо. Платформи на кшталт Vals автоматизують цей процес для більших масштабів.
Підсумок
Vals і a16z не просто будують продукт — вони формують інфраструктуру довіри для AI-ринку. Бенчмарки перестають бути академічним інструментом і стають частиною закупівельного процесу. Для підприємств це означає одне: час навчитися вимірювати AI так само строго, як вимірюють будь-який інший бізнес-інструмент.
Хочете розібратися, як побудувати власний процес оцінки AI-агентів для вашого бізнесу? Зв'яжіться з нами — допоможемо скласти тестовий фреймворк під ваші задачі.
Є питання? Запитайте AI-агента прямо зараз
Відповідає за секунди, знає все про наші послуги та допоможе розібратися у вашій ситуації
Читайте також
Галюцинація AI мало не розпочала війну
AI-галюцинації — не просто технічний баг. Вони можуть спровокувати реальні кризи. Розбираємо, як бізнес має захищатися від помилок агентів.
EnterpriseAnthropic & Accenture: вбудована оцінка AI
Anthropic і Accenture вкладають по $1 млрд у вбудовану оцінку AI-моделей. Що це означає для підприємств, які розгортають AI-агентів у критичних процесах.
EnterprisePrompt Injection у GPT-6 Astra: ризики для фінансів
GPT-6 Astra блокує 99,99% прямих атак — але 8,5% непрямих ін'єкцій проходять. Що це означає для фінансових AI-агентів і як будувати захист.