
Anthropic & Accenture: вбудована оцінка AI
Anthropic і Accenture вкладають по $1 млрд у вбудовану оцінку AI-моделей. Що це означає для підприємств, які розгортають AI-агентів у критичних процесах.
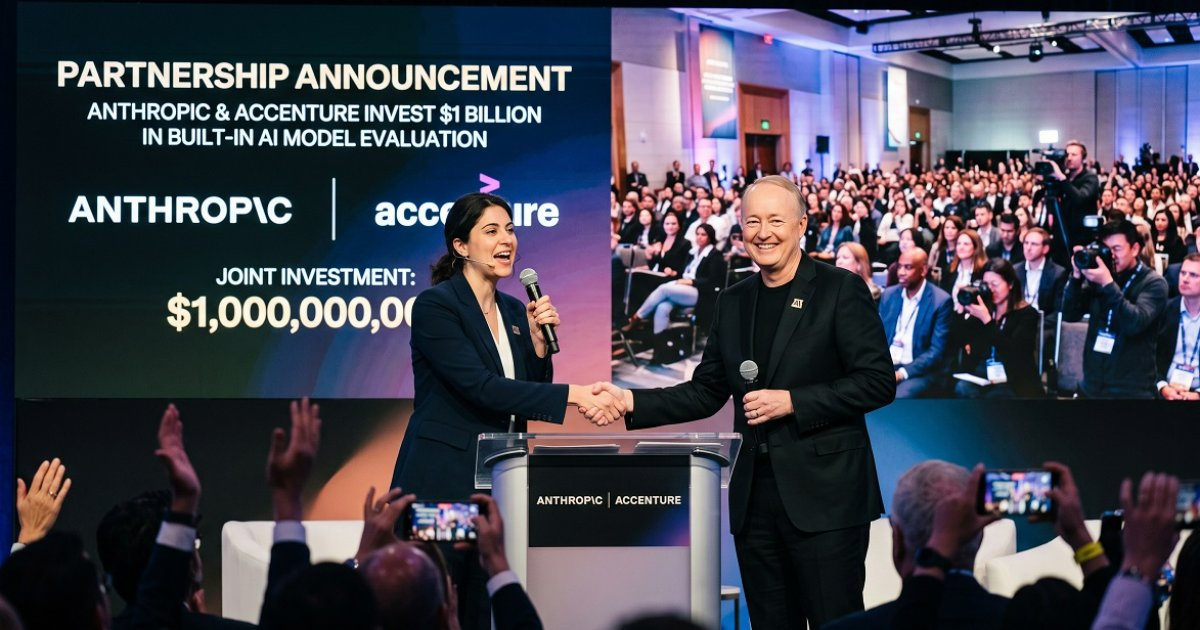
Ставка на $2 мільярди заради AI, якому можна довіряти
Anthropic і Accenture кожна зобов'язалися вкласти щонайменше $1 млрд протягом п'яти років — разом $2 млрд — щоб побудувати те, що вони називають новою моделлю нагляду за безпекою frontier-AI. Це не маркетинговий бюджет. Це ціна структурної відповіді на питання, яке кожен корпоративний покупець AI тихо ставив собі роками: хто стежить за моделлю?
Відповідь виявилася такою: людина, яка сидить за столом усередині лабораторії, має перепустку і працює на іншу компанію. Що ця схема означає для розгортання AI у бізнесі — і чому момент важливіший, ніж більшість коментаторів визнає, — про це і стаття.
Що насправді означає «вбудована оцінка»
Термін звучить технічно, але за ним стоїть зрозумілий прецедент. Сам Амодеї вказав на нього в есе «We Must Pace the Frontier» від 12 вересня 2026 року: банківська галузь давно практикує розміщення регуляторних наглядачів усередині фінансових установ — з доступом рівня співробітника, щоб перевіряти, чи відповідають реальні практики управління ризиками публічним зобов'язанням. Вбудована оцінка AI — та сама логіка, застосована до frontier-моделей.
18 вересня 2026 року Anthropic і Accenture офіційно оголосили про партнерство: команда вбудованих оцінювачів працюватиме поруч із внутрішніми командами Anthropic. Оцінювачів залучають із Faculty — спеціалізованого AI-підрозділу Accenture. Вони оцінюватимуть і «червоно тестуватимуть» моделі, проводитимуть оцінку вирівнювання та перевірятимуть захисні механізми. Головне: вони матимуть постійний доступ із правами, порівнянними з правами внутрішніх співробітників, які виконують аналогічну роботу з оцінки ризиків, — столи в офісах Anthropic, перепустки, корпоративні ноутбуки.
Це не разовий зовнішній аудит. Це безперервний нагляд зсередини будівлі від людей, які не перебувають у штаті Anthropic.
Незалежна оцінка — це не галочка у чеклісті. Це різниця між пожежним навчанням і пожежним інспектором, який ніколи не залишає будівлю.
Чому Faculty і чому зараз
Accenture придбала Faculty — одну з провідних прикладних AI-компаній у світі — саме для того, щоб сформувати глибоку технічну спроможність у сфері безпеки. Послужний список Faculty охоплює державний сектор, оборону, охорону здоров'я та критичну інфраструктуру, зокрема розробку системи раннього попередження Національної служби охорони здоров'я Великої Британії під час пандемії COVID-19. Це важливо: перед нами не консалтингова команда, яка щойно взялася вивчати AI-безпеку. Це організація, яка роками будувала складні AI-системи, де безпека закладена в архітектуру, а не додана поверх готового продукту.
Вибір моменту теж не випадковий. Есе Амодеї вийшло за шість днів до оголошення партнерства — і це не збіг. Есе представило триступеневу структуру: вбудовані оцінювачі, демократична координація між AI-лабораторіями і, зрештою, глобальна координація. Вбудована оцінка — єдиний крок, до якого Anthropic зобов'язалася в односторонньому порядку. Угода з Accenture — перша конкретна реалізація цього зобов'язання.
Питання доступу
Те, що принципово відрізняє цю схему від звичайних аудитів третьої сторони, — глибина доступу. Традиційний аудит ретроспективний: зовнішня команда переглядає документацію, запускає тести на вже випущених моделях і готує звіт. Вбудована оцінка — проспективна і безперервна: оцінювачі присутні під час прийняття рішень у навчальному конвеєрі, а не лише після того, як модель вийшла.
Структура Амодеї передбачає, що вбудовані оцінювачі мають перевіряти дотримання практик безпеки, фіксувати інциденти та оцінювати вирівнювання навчальних конвеєрів і процесів — не лише готових моделей. Це суттєво ширший обсяг, ніж будь-що, що раніше формалізовувалося на корпоративному AI-ринку.
Чому це змінює корпоративну логіку щодо AI
Для CEO або COO, який розгортає AI у критичних бізнес-процесах — затвердження закупівель, комплаєнс-процеси, фінансовий контроль, — питання ніколи не було «чи добре ця модель виступає на бенчмарках?». Питання завжди було: «якщо модель припуститься серйозної помилки, хто несе відповідальність і як я взагалі про це дізнаюся?»
До цього моменту на це питання не було структурної відповіді. AI-лабораторії самостійно сертифікують свої продукти. Картки безпеки пишуть ті самі команди, що будували модель. Червоне тестування проводиться внутрішньо, а результати розкриваються вибірково. Корпоративний покупець не мав жодного незалежного сигналу, на який міг би спертися.
Вбудована оцінка змінює цю архітектуру. Коли незалежна команда з доступом рівня співробітника безперервно оцінює поведінку моделі — включно з її вирівнюванням із людськими цінностями, а не лише бенчмарк-показниками, — корпоративний покупець отримує щось справді нове: сигнал від третьої сторони, структурно відокремленої від комерційних інтересів лабораторії.
Корпоративний покупець AI три роки приймав рішення про розгортання без незалежного сигналу. Цей розрив закривається — і компанії, які розуміють, що це означає, рухатимуться швидше за тих, хто досі чекає на повну визначеність.
Розрив у підзвітності при корпоративному розгортанні AI
Уявіть, що відбувається, коли AI-агент припускається помилки у процесі з високими ставками. Агент закупівель схвалює постачальника, якого мали відхилити. Комплаєнс-процес неправильно класифікує транзакцію. Інструмент перевірки контрактів пропускає пункт про відповідальність. У кожному з цих випадків операційні та юридичні наслідки несе бізнес. Постачальник моделі — майже жодних.
Ця асиметрія і є тихим гальмом масштабного впровадження корпоративного AI. Ради директорів і юридичні команди мали рацію бути обережними — не тому, що AI не працює, а тому, що архітектура підзвітності навколо нього залишалася незрілою. Вбудована оцінка — перша структурна відповідь на цю незрілість, яка надходить зсередини frontier-лабораторії, а не від регулятора.
Для бізнесів, які вже досліджують архітектури AI-агентів — тих, що прибирають людські вузькі місця із закупівельних і погоджувальних процесів, — цей зсув у моделі нагляду безпосередньо стосується розмови про ризики з вашою радою директорів.
Що говорить сигнал у $2 мільярди
На цифрі сукупних інвестицій варто зупинитися. Ні Anthropic, ні Accenture не ставляться до цього як до пілоту чи PR-акції. По $1 млрд кожна протягом п'яти років — обидві організації будують інституційну спроможність: наймають людей, розробляють інструменти та процеси, які переживуть будь-який окремий цикл випуску моделей.
Такий масштаб зобов'язань сигналізує ринку: оцінка безпеки стає інфраструктурою, а не функцією. Так само, як хмарні провайдери вбудували резервування та гарантії доступності у своє базове пропозиційне значення — бо корпоративні покупці цього вимагали, — AI-лабораторії тепер вбудовують незалежний нагляд у процес розробки, бо альтернатива — самосертифікація на рівні frontier-можливостей — більше не є переконливою.
Anthropic також прямо заявила, що партнерство не є ексклюзивним. Компанія очікує оголосити про додаткових оцінювачів найближчими тижнями, а Accenture, за очікуваннями, працюватиме з іншими AI-розробниками в аналогічних ролях. Мета, як зазначено в офіційному оголошенні, — екосистема оцінювачів зі спільними стандартами, а не двостороння угода між двома компаніями.
Що бізнесу робити з цією інформацією
Партнерство Anthropic і Accenture — не те, з чим більшість бізнесів взаємодіятиме безпосередньо. Ви не наймаєте Faculty. Ви не сидите в офісах Anthropic. Але структура, яку воно встановлює, має прямі наслідки для того, як ви оцінюєте та закуповуєте AI-системи надалі.
Переосмисліть перевірку постачальників
Стандартний корпоративний чеклист для закупівлі AI — відповідність SOC 2, розміщення даних, SLA щодо доступності — розроблявся для програмного забезпечення, а не для систем, які міркують, вирішують і діють. Модель, яка проходить аудит SOC 2, може водночас видавати систематично упереджені результати, галюцинувати в специфічних доменних контекстах або поводитися під adversarial-запитами зовсім не так, як на демо.
Питання, яке варто додати до розмов із постачальниками, пряме: чи має незалежна третя сторона постійний доступ для оцінки поведінки цієї моделі, і чи можете ви показати мені її висновки? Це питання відокремить постачальників, які серйозно думали про підзвітність, від тих, хто цього не робив. І саме це питання ваша рада директорів і юридичний радник зрештою поставлять вам — краще мати відповідь заздалегідь.
Керівники, які можуть зайти на засідання ради і пояснити не лише що роблять їхні AI-системи, а й як ці системи незалежно верифікуються, — саме вони перетворюють впровадження AI з розмови про відповідальність на розмову про конкурентну перевагу. Цей зсув у сприйнятті — від людини, яка бере технологічний ризик, до людини, яка управляє ним із суворістю, — коштує більше, ніж будь-який окремий виграш в ефективності.
Розрізняйте безпеку і відповідність вимогам
Ці два поняття часто плутають у корпоративних AI-розмовах, і ця плутанина дорого коштує. Відповідність вимогам — це дотримання визначеного стандарту: чеклісту, регуляції, сертифікації. Безпека — це те, що система поводиться так, як задумано, на всьому реальному розподілі вхідних даних, включно з граничними випадками, яких чеклист не передбачав.
Вбудована оцінка покликана закрити розрив між цими двома поняттями. Модель може повністю відповідати всім чинним AI-регуляціям і водночас давати збій у способах, які регуляторні рамки ще не визначили. Цінність безперервної незалежної оцінки саме в тому, що вона працює попереду регуляторної кривої — виявляє режими відмов до того, як вони стають інцидентами.
Для бізнесів у регульованих галузях — фінансових послугах, охороні здоров'я, юридичній сфері — це розрізнення не академічне. Ризики розгортання AI-систем без незалежної верифікації асиметричні: виграш від швидшого розгортання — поступовий, програш від гучного провалу — репутаційний і потенційно юридичний.
Паралельно будуйте внутрішню спроможність оцінки
Модель Anthropic і Accenture розроблена для frontier-лабораторій. Але базовий принцип — люди, які будують систему, не мають бути єдиними, хто її оцінює, — діє на будь-якому масштабі розгортання AI.
Якщо ваша організація розгортає AI-агентів у критичних процесах, мінімально прийнятна версія цього принципу — структурований внутрішній процес перевірки, організаційно відокремлений від команди, яка будувала або обирала систему. Це означає, що хтось у вашій функції ризику, комплаєнсу або операцій відповідає за процес оцінки — а не технологічна команда, яка просувала це розгортання.
Це не бюрократія заради бюрократії. Це та сама логіка, яка відокремлює функцію CFO від бізнес-підрозділів, чиї цифри CFO аудитує. Незалежність — це механізм, який робить сигнал достовірним.
Коли така структура є, щось змінюється для тих, хто керує бізнесом: постійна фонова тривога — чи робить AI те, що має робити, — замінюється процесом. Це не дрібниця. Операційний спокій — здатність приймати рішення щодо розгортання AI з позиції верифікованої впевненості, а не освіченого здогаду — дозволяє керівництву зосередитися на стратегії замість гасіння пожеж.
FAQ
Що таке вбудована оцінка AI і чим вона відрізняється від стандартного аудиту? Вбудований оцінювач має постійний доступ рівня співробітника до систем, процесів і навчальних конвеєрів AI-лабораторії — а не лише до готових моделей після випуску. Стандартний аудит ретроспективний і періодичний; вбудована оцінка — безперервна і проспективна, охоплює оцінку вирівнювання та практики безпеки в реальному часі.
Чому Anthropic обрала Accenture першим вбудованим оцінювачем? Accenture залучає Faculty — свій спеціалізований AI-підрозділ — із підтвердженим досвідом оцінки моделей для провідних AI-лабораторій і побудови систем із безпекою за конструкцією в державному секторі, обороні та охороні здоров'я. Партнерство не є ексклюзивним: Anthropic заявила, що оголосить про додаткових оцінювачів, а Accenture, за очікуваннями, працюватиме з іншими AI-розробниками в аналогічних ролях.
Скільки Anthropic і Accenture інвестують у цю програму? Кожна компанія зобов'язалася вкласти щонайменше $1 млрд протягом п'яти років — разом мінімум $2 млрд на розбудову спроможності вбудованої оцінки. Anthropic фінансує роботу Accenture безпосередньо, водночас досліджуючи довгострокові моделі об'єднаного або державного фінансування для ширшої екосистеми оцінювачів.
Чи впливає це партнерство на бізнеси, які використовують Claude або API Anthropic? Не безпосередньо — але воно змінює архітектуру підзвітності навколо моделей, які ви розгортаєте. Незалежна оцінка вирівнювання та захисних механізмів моделі дає сигнал від третьої сторони, якого раніше корпоративні покупці не мали, — і це стосується будь-якої розмови про ризики чи комплаєнс щодо розгортання AI.
Чи є вбудована оцінка регуляторною вимогою? Поки що ні. Anthropic взяла на себе цей крок в односторонньому порядку і закликала уряди зобов'язати інші frontier-лабораторії зробити те саме. Станом на дату оголошення жодна обов'язкова регуляція не вимагає вбудованої оцінки — але структура розроблена сумісною з майбутніми регуляторними вимогами, а прецедент із банківського регулювання підказує: добровільне прийняття зазвичай передує обов'язковим стандартам.
Що бізнесу робити прямо зараз у відповідь на цей розвиток? Оновіть процес перевірки AI-постачальників, додавши питання про незалежну оцінку. Побудуйте внутрішні процеси перевірки, організаційно відокремлені від команд, які розгортають AI. І сприймайте модель Anthropic і Accenture як попередній перегляд того, куди рухаються стандарти підзвітності корпоративного AI, — а не як далекий розвиток, що не стосується ваших рішень про закупівлі сьогодні.
Партнерство Anthropic і Accenture — на ранній стадії: деталі реалізації ще опрацьовуються, а галузь вбудованої оцінки не має усталених стандартів. Але напрямок зрозумілий. Незалежний безперервний нагляд за AI-системами переходить зі сфери прагнень в інфраструктуру. Бізнеси, які вже зараз будують свої AI-governance-структури навколо цієї реальності — замість того щоб чекати, поки регулювання змусить їх це зробити, — матимуть чистіші розмови з радою директорів, швидші цикли розгортання і конкурентну перевагу, яку дає довіра до прийняття важливих рішень.
Якщо хочете зрозуміти, як структури незалежної оцінки AI застосовуються до вашого конкретного контексту розгортання, замовте 15-хвилинну консультацію.
Є питання? Запитайте AI-агента прямо зараз
Відповідає за секунди, знає все про наші послуги та допоможе розібратися у вашій ситуації
Читайте також
Галюцинація AI мало не розпочала війну
AI-галюцинації — не просто технічний баг. Вони можуть спровокувати реальні кризи. Розбираємо, як бізнес має захищатися від помилок агентів.
EnterpriseVals & a16z: як AI-бенчмарки вирішують все
Vals і a16z змінюють правила оцінки AI-агентів: чому бенчмарки тепер визначають, кого обирає бізнес і скільки коштує помилка вибору.
EnterprisePrompt Injection у GPT-6 Astra: ризики для фінансів
GPT-6 Astra блокує 99,99% прямих атак — але 8,5% непрямих ін'єкцій проходять. Що це означає для фінансових AI-агентів і як будувати захист.