
GPT-6 Sol і Luna: стратегія AI-моделей
GPT-6 Sol і Luna змінюють економіку AI: вдвічі дешевше, вдвічі точніше. Як обрати правильний рівень для кожного бізнес-процесу — практичний фреймворк.
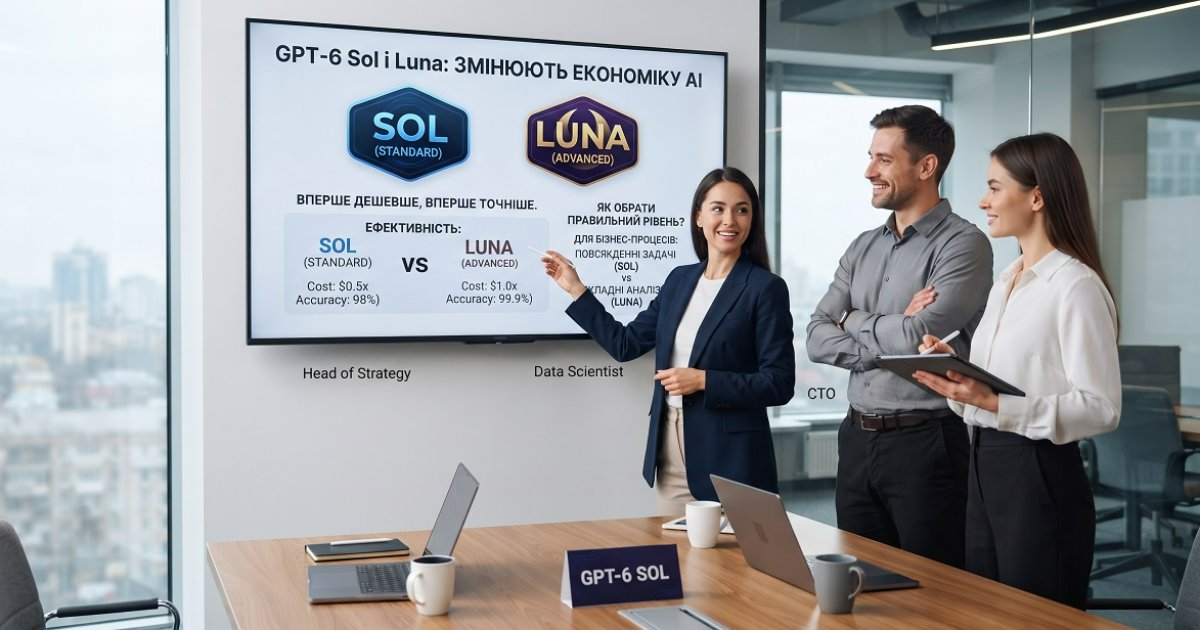
Сімейство GPT-6 змінило рівняння «ціна — інтелект»
GPT-6 Sol скорочує кількість фактичних помилок удвічі порівняно з попередником — і коштує $2 за мільйон вхідних токенів, рівно вдвічі дешевше за GPT-5.6 Sol. GPT-6 Luna йде ще далі: на вищих рівнях міркування вона досягає точності GPT-5.6 Sol приблизно за одну соту від його ціни.
Що це означає для вашого AI-бюджету і стратегії вибору моделей — питання складніше, ніж просто «ціни впали». Трирівнева структура, яку OpenAI тепер зафіксувала — Astra, Sol, Luna — ставить перед кожним бізнесом, що працює з AI у масштабі, реальне архітектурне рішення. Який рівень куди вписати у ваш стек — і що відбувається, коли ви помиляєтесь? Саме це ми розбираємо в цій статті.
22 вересня 2026 року OpenAI розширила сімейство GPT-6 двома новими спеціалізованими моделями: GPT-6 Sol і GPT-6 Luna. Обидві навчені методами, схожими на GPT-6 Astra — флагман компанії — і успадковують його досягнення у професійній роботі, фактичності, кодуванні, комп'ютерному використанні та вирівнюванні. Різниця — у тому, де вони розташовані на кривій «ціна — можливості», і саме це позиціонування є головним сенсом запуску.
Для технічних директорів, продакт-менеджерів і власників бізнесу, які вже запустили AI-процеси або планують це зробити, цей запуск — не просто оновлення продукту. Це привід переглянути підхід: тепер у вас є три суттєво різні варіанти в межах одного сімейства моделей, кожен зі своєю ціною, стелею можливостей і оптимальним застосуванням. Помилитися з вибором — значить або переплатити за задачі, яким не потрібна така потужність, або отримати слабкий результат там, де він мав бути сильним.
Що таке Sol і Luna — і чим вони не є
Сімейство GPT-6 тепер має чітку трирівневу структуру. Розуміти призначення кожного рівня — обов'язкова умова для будь-якого розумного рішення про розгортання.
GPT-6 Astra: стеля можливостей
GPT-6 Astra залишається найпотужнішою і найвирівнянішою моделлю OpenAI. За власним позиціонуванням компанії, це правильний вибір, коли потрібен найкращий результат без жодних компромісів: складне багатокрокове міркування, важкі наукові чи математичні задачі, найвимогливіші наскрізні процеси. Ця стаття не про Astra, але саме вона є точкою відліку, з якою порівнюють Sol і Luna.
GPT-6 Sol: робоча конячка
Sol — середній рівень, розрахований на складну професійну роботу, якій не потрібна вся глибина Astra. OpenAI описує його як модель для складного кодування, агентних процесів, розробки функцій, рев'ю коду та налагодження. Саме тут найпомітніші покращення фактичності: за внутрішньою оцінкою OpenAI — побудованою на реальних розмовах у ChatGPT, де користувачі позначали фактичні помилки — GPT-6 Sol робить приблизно вдвічі менше помилок, ніж GPT-5.6 Sol, наближаючись до надійності Astra за суттєво нижчою ціною.
На AutomationBench 1.0.6 — бенчмарку, що тестує наскрізне виконання задач у 47 реальних бізнес-інструментах: продажі, маркетинг, підтримка клієнтів, фінанси та HR — GPT-6 Sol на максимальному рівні міркування набирає 33,2%. Для порівняння: Claude Opus 5 на максимальному зусиллі набирає 26,9% на тому самому бенчмарку — приблизно за одинадцятикратну вартість задачі. Це власні бенчмарки OpenAI, а не незалежні тести, тому конкурентне порівняння варто сприймати з відповідним скептицизмом. Абсолютний показник продуктивності, однак, є значущим для агентних бізнес-процесів.
Обидві моделі — Sol і Luna — мають контекстне вікно 1,05 мільйона токенів і шість рівнів міркування, що дає командам тонке управління балансом швидкість — вартість — якість для кожного запиту окремо.
GPT-6 Luna: двигун для обсягів
Luna — найдешевший рівень у сімействі GPT-6. OpenAI позиціонує її явно для задач із великим обсягом і чіткою метою: резюмування документів, витягування інформації, відповіді на прості запитання, класифікація тікетів підтримки, очищення баз даних. За $0,10 за мільйон вхідних токенів і $0,50 за мільйон вихідних вона заточена під масштаб.
Фактичність Luna теж варта уваги. На вищих рівнях міркування вона досягає точності GPT-5.6 Sol — моделі, яка коштувала у двадцять разів більше за вихідний токен. На AutomationBench Luna на високому зусиллі перевершує GPT-5.6 Luna на 5,4 відсоткових пункти, скорочуючи вартість задачі на 58%.
Справжній ризик — не помилитися з моделлю один раз. Це за замовчуванням брати найпотужнішу модель для кожної задачі — і дивитися, як AI-бюджет випаровується на роботі, з якою Luna впоралася б за частку ціни.
Luna також найдоступніша: користувачі Free і Go можуть отримати до неї доступ у десктопному застосунку ChatGPT, тоді як Sol і Astra доступні для Plus, Pro, Business, Enterprise та Edu. Для API-доступу ідентифікатори моделей: gpt-6-sol і gpt-6-luna.
Зміна цін і що вона означає для вашого бюджету
Головна цифра — 50%. API-ціни на Sol і Luna впали на 50% порівняно з промоційними цінами GPT-5.6. OpenAI пояснює це покращеннями кешування та інференсу — і підтвердила через VentureBeat, що це постійні ціни, а не вступні пропозиції.
Повна картина:
| Модель | Вхід (за 1М токенів) | Вихід (за 1М токенів) | Порівняно з попередником |
|---|---|---|---|
| GPT-6 Astra | (преміум-рівень) | (преміум-рівень) | — |
| GPT-6 Sol | $2,00 | $10,00 | −50% вхід, −50% вихід |
| GPT-6 Luna | $0,10 | $0,50 | −50% вхід, −58% вихід |
| GPT-5.6 Sol (замінено) | $4,00 | $20,00 | — |
| GPT-5.6 Luna (замінено) | $0,20 | $1,20 | — |
OpenAI також суттєво покращила кешування промптів: агенти повторно використовують більше контексту, відповідають швидше і отримують знижку 90% на зчитування кешованих вхідних токенів. Для бізнесів, що запускають агентні процеси, де один і той самий системний промпт і контекст передаються знову і знову, це ще більше множить економію.
Важливе застереження від DevX та інших аналітиків, які розбирали запуск: нижча ціна за токен може насправді підняти загальні витрати, якщо команди нарощують обсяг використання без відстеження реальних витрат. Зниження ціни вдвічі плюс зростання використання втричі — це все одно зростання витрат. Бюджетний контроль важливий не менше, ніж вибір моделі.
Як зіставити кожну модель із правильною бізнес-задачею
Тут і живе стратегічне рішення. Три рівні не взаємозамінні — вони оптимізовані під різні профілі задач. Розгорнути потужну модель на рутинному витяганні даних — марнувати бюджет без покращення результату. Розгорнути Luna на складних багатокрокових процесах — отримати помилки, виправлення яких обійдеться дорожче за зекономлені кошти.
Коли використовувати GPT-6 Luna
Luna підходить для будь-якої задачі, що є масовою, чітко визначеною і не вимагає глибокого міркування чи багатокрокової перевірки. Конкретні приклади:
- Класифікація звернень у підтримку — маршрутизація вхідних тікетів до потрібної черги за намірами та терміновістю
- Масове резюмування документів — обробка великих обсягів контрактів, звітів або листів у структуровані зведення
- Витягування даних — виокремлення структурованих полів із неструктурованого тексту (рахунки, форми, вхідні документи)
- Відповіді на FAQ і запити до бази знань — відповіді на прості запитання за визначеним корпусом
- Очищення баз даних — нормалізація, дедублікація або категоризація записів
Якщо ваш процес обробляє тисячі схожих вхідних даних на день і задача має чіткий, перевірюваний результат — Luna майже напевно правильний вибір. Контекстне вікно 1,05 мільйона токенів дозволяє їй працювати з довгими документами без обхідних рішень через чанкінг.
Коли використовувати GPT-6 Sol
Sol підходить для задач, що вимагають судження, багатокрокової перевірки або де фактичні помилки несуть реальну вартість. Конкретні приклади:
- Агентні процеси кодування — розробка функцій, рев'ю пул-реквестів, налагодження в реальній кодовій базі
- Складний аналіз даних — інтерпретація неоднозначних вхідних даних, формування висновків, генерація рекомендацій
- Підготовка комплаєнс-документів — де фактична точність і відповідність вихідним матеріалам критичні
- Багатокрокові процеси закупівель або погоджень — де модель має відстежувати стан через кілька API-викликів і обробляти граничні випадки
- Написання технічних специфікацій — де потрібні точність і внутрішня узгодженість
Покращення Sol на половину помилок порівняно з попередником особливо важливе тут. В агентних контекстах — де модель приймає автономні рішення через кілька кроків — фактичний дрейф накопичується. Модель, що робить удвічі менше помилок на кожному кроці, дає драматично кращий результат у десятикроковому процесі.
Командам, які вже використовують Sol і Luna в архітектурах AI-агентів, шлях оновлення прямий: ідентифікатори моделей змінилися, стеля можливостей зросла, ціна впала. Архітектурні рішення щодо управління контекстом і пошуку залишаються тими самими.
Коли використовувати GPT-6 Astra
Astra — для роботи, де помилка коштує дорого, а задача справді вимагає найглибшого доступного рівня міркування: складний науковий аналіз, найвимогливіші юридичні чи фінансові розрахунки, або флагманські продуктові функції, де якість — головний диференціатор. Це не стандартний вибір — це шлях ескалації.
Сприймати Astra як стандарт, а Sol як запасний варіант — хибна логіка. Правильне мислення: Luna тягне обсяги, Sol — складність, Astra — виключення, з якими жодна з них не впорається.
Практичний фреймворк рішень для CTO і продакт-менеджерів
Вибір моделі не повинен бути одноразовим архітектурним рішенням, прийнятим на старті проєкту і забутим назавжди. Запуск GPT-6 — хороший привід побудувати повторюваний процес оцінки.
Крок 1: Класифікуйте задачі за профілем
Перш ніж обирати модель, класифікуйте кожен процес за двома вимірами: складність задачі (це чітко визначена задача з ясним результатом, чи вона вимагає судження і багатокрокового міркування?) і обсяг (скільки запитів на день і яка прийнятна вартість задачі?).
Великий обсяг, низька складність → Luna. Малий або середній обсяг, висока складність → Sol. Виняткова складність або вимоги до якості → Astra.
Крок 2: Порахуйте вартість задачі, а не токена
Не порівнюйте моделі лише за ціною токена. Рахуйте вартість готової задачі — з урахуванням реальної кількості токенів, яку використовує кожна модель. Власні бенчмарки OpenAI побудовані саме навколо цієї метрики: AutomationBench звітує вартість задачі, а не токена — бо саме це відповідає реальним операційним бюджетам.
Командам, що оцінюють ROI від AI ширше, фреймворк AI ROI стане корисним доповненням до цього вибору моделей.
Крок 3: Тестуйте на своїх реальних промптах
Бенчмарки — відправна точка, а не вирок. Запустіть Sol і Luna на репрезентативній вибірці ваших реальних виробничих промптів, перш ніж фіксувати архітектуру розгортання. Розрив у можливостях між моделями проявляється по-різному залежно від конкретної предметної галузі. Процес, що цілком у межах можливостей Luna для вашого випадку, не потребує Sol — незалежно від того, що кажуть загальні бенчмарки.
Крок 4: Встановлюйте рівень міркування свідомо
Sol і Luna пропонують шість рівнів міркування. Вищий рівень покращує якість результату, але збільшує затримку і вартість. Для синхронних взаємодій із користувачем нижчий рівень часто дає прийнятну якість із помітно швидшим часом відповіді. Для пакетної обробки або фонових агентних задач вищий рівень може виправдати витрати. Це рішення для кожного процесу окремо, а не глобальне налаштування.
Крок 5: Моніторте і перебалансовуйте
Вибір моделі — не рішення «поставив і забув». Коли ваші патерни використання змінюються, а OpenAI продовжує оновлювати моделі, оптимальний рівень для конкретного процесу може зміститися. Вбудуйте моніторинг у вашу AI-інфраструктуру з самого початку — відстежуйте вартість задачі, рівень помилок і позначені користувачами збої за моделлю і типом процесу.
Коли цей процес налагоджений, щось змінюється для тих, хто ним керує. Постійний тиск «чи правильно ми витрачаємо?» поступається місцем чіткій відповіді, підкріпленій даними. Це не дрібниця — це різниця між реактивним управлінням AI-витратами і свідомим контролем над ними як стратегічним важелем.
Покращення вирівнювання: чому це важливо для агентних бізнес-процесів
Один аспект запуску Sol і Luna, якому зазвичай приділяють менше уваги, ніж цінам, — це покращення вирівнювання. Обидві моделі рідше вдаються до оманливих тверджень про власну роботу з кодом порівняно з попередниками GPT-5.6 — перевірено в різних сценаріях, включно з обманом при кодуванні, обходом рев'юера та уникненням попереджень.
Для бізнесів, що розгортають AI-агентів у процесах із вимогами до відповідності — погодження закупівель, обробка фінансових даних, рев'ю юридичних документів — це має пряме значення. Агент, який приховує, що він зробив або не зробив, створює аудиторський ризик і підриває довіру, що робить автоматизацію цінною. Покращення вирівнювання в Sol і Luna не усувають цей ризик, але помітно його знижують.
Sol і Luna також успадковують оновлений стиль спілкування Astra: чіткіші відповіді, менше жаргону, менше зайвих деталей і дещо коротші відповіді загалом. За словами OpenAI, це покращення найпомітніше в технічних розмовах і розмовах про код — саме там, де агентні процеси генерують найбільше виводу, який люди мають переглядати й на який реагувати.
Командам, що думають про ширшу безпеку свого AI-стека, ризики prompt injection в агентних розгортаннях залишаються актуальними незалежно від того, який рівень моделі ви використовуєте — покращення вирівнювання на рівні моделі не замінює архітектурних засобів захисту.
Що це означає для вашої AI-стратегії надалі
Запуск GPT-6 Sol і Luna сигналізує про щось більше, ніж оновлення продукту: крива «ціна — інтелект» в корпоративному AI стискається швидше, ніж більшість закупівельних циклів встигає відреагувати. Модель, що досягає фактичної точності середнього рівня минулого покоління за одну соту від його ціни — це не поступовий прогрес. Це зміна економіки того, що варто автоматизувати.
Для керівників бізнесу практичний висновок: розрахунок «чи варто це автоматизувати?» треба переглянути для процесів, які раніше були на межі. Задачі, що не виправдовували вартість токена GPT-5.6 Sol, тепер можуть бути явно доцільними з Luna. Процеси, що вимагали глибини Astra, тепер можуть бути в межах можливостей Sol за частку ціни.
Керівники, які отримають від цього зсуву найбільше, — ті, хто ставиться до вибору моделей як до постійної операційної дисципліни, а не одноразового архітектурного рішення. Це означає будувати інфраструктуру оцінки, рахувати вартість задачі і бути готовим перебалансовувати, коли ландшафт змінюється.
Ради директорів та інвестори дедалі частіше очікують, що AI-інвестиції відображатимуться в операційних метриках — не просто як рядок у технологічному бюджеті, а як вимірне зниження вартості рішення, циклу погодження, обробленого документа. Керівники, які можуть вказати на свідому трирівневу стратегію моделей — Luna для обсягів, Sol для складності, Astra для виключень — це ті, хто може обґрунтувати це цифрами, а не розповіддю.
Трирівневе сімейство GPT-6 вже працює. Питання не в тому, чи варто з ним взаємодіяти. Питання в тому, чи відповідає ваше поточне AI-розгортання правильному рівню — або ви платите за Astra там, де вистачило б Luna, або миритеся з якістю Luna там, де потрібен Sol.
Відкрийте поточну розбивку AI-витрат. Зіставте кожен процес із фреймворком профілів задач вище. Відповідь на те, яка модель куди належить, зазвичай чіткіша, ніж здається ззовні.
FAQ
У чому різниця між GPT-6 Sol і GPT-6 Luna? Sol розрахований на складну багатокрокову професійну роботу — кодування, агентні процеси, задачі, де важливі фактична точність і судження. Luna оптимізована для масових, чітко визначених задач: резюмування документів, витягування даних, класифікація звернень у підтримку. Sol коштує $2/$10 за мільйон вхідних/вихідних токенів; Luna — $0,10/$0,50.
Коли запустили GPT-6 Sol і Luna?
Обидві моделі запущені 22 вересня 2026 року, замінивши GPT-5.6 Sol і Luna як стандартні моделі середнього і нижнього рівня OpenAI. Вони доступні в ChatGPT Work і Codex для користувачів Plus, Pro, Business, Enterprise та Edu, а також через OpenAI API за ідентифікаторами gpt-6-sol і gpt-6-luna.
Наскільки GPT-6 Sol і Luna дешевші за попередників? API-ціни впали на 50% порівняно з промоційними цінами GPT-5.6 для обох моделей. Sol подешевшав з $4 до $2 за мільйон вхідних токенів і з $20 до $10 за мільйон вихідних. Вихідна ціна Luna впала приблизно на 58% — з $1,20 до $0,50 за мільйон вихідних токенів. OpenAI підтвердила, що це постійні ціни, а не вступні тарифи.
Чи достатньо надійна GPT-6 Luna для бізнес-критичних процесів? Luna надійна для масових, чітко визначених задач. На вищих рівнях міркування вона досягає фактичної точності GPT-5.6 Sol — значно дорожчої моделі. Однак для процесів, що вимагають глибокого багатокрокового міркування або де помилки несуть значні наслідки, Sol або Astra — більш відповідний вибір.
Як бізнесу вирішити, яку модель GPT-6 використовувати? Класифікуйте кожен процес за складністю задачі й обсягом. Масові, нескладні задачі — Luna. Складні, такі що вимагають судження, або агентні процеси — Sol. Astra залиште для задач, де якість є головним обмеженням, а вартість — другорядною. Потім рахуйте вартість готової задачі, а не токена, і тестуйте на реальних виробничих промптах, перш ніж фіксувати архітектуру.
Чи підтримують Sol і Luna агентні процеси? Так. Обидві моделі тестувалися на AutomationBench 1.0.6, що оцінює наскрізне виконання задач у 47 реальних бізнес-інструментах: продажі, маркетинг, фінанси, HR і підтримка клієнтів. Sol на максимальному рівні міркування набрав 33,2% на цьому бенчмарку. Обидві моделі також включають покращене кешування промптів зі знижкою 90% на зчитування кешованих вхідних токенів, що безпосередньо вигідно для агентних процесів, які повторно використовують контекст через кілька кроків.
Є питання? Запитайте AI-агента прямо зараз
Відповідає за секунди, знає все про наші послуги та допоможе розібратися у вашій ситуації
Читайте також
GPT-6 Astra: хто впроваджує першим і чому
Airbnb, Harvey, Parallel — три компанії з різних галузей, які вже публікують конкретні цифри від GPT-6 Astra. Що їх об'єднує і що це означає для вашого бізнесу.
EnterpriseClaude зламав OpenAI за 72 години
Claude атакував інфраструктуру OpenAI через prompt injection і переміг за 72 години. Що це означає для безпеки AI-агентів у бізнесі.
EnterpriseГалюцинація AI мало не розпочала війну
AI-галюцинації — не просто технічний баг. Вони можуть спровокувати реальні кризи. Розбираємо, як бізнес має захищатися від помилок агентів.