
RAG vs CAG: яку AI-архітектуру обрати
RAG чи CAG — яка архітектура підходить вашому бізнесу? Чотири питання, які визначають вибір, і реальний кейс зниження витрат на 60%.
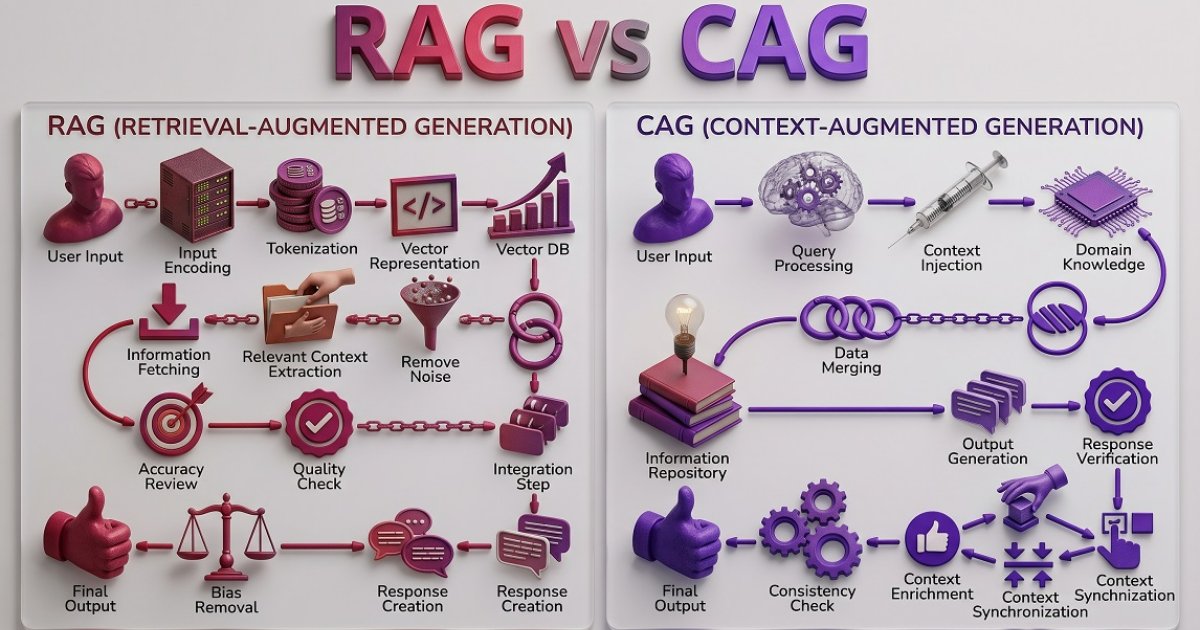
RAG vs CAG: архітектурне рішення, яке більшість AI-проєктів приймає неправильно
Ще донедавна "додай векторну базу даних" було стандартною відповіддю майже на будь-яке корпоративне AI-питання. Команда хоче внутрішнього асистента зі знань? RAG. Бот для підтримки клієнтів? RAG. Перевірка відповідності нормативам? RAG. Патерн був настільки домінуючим, що більшість проєктів навіть не зупинялася, щоб запитати: а чи потрібен тут пошук взагалі? Просто починали будувати пайплайн.
Цей рефлекс варто поставити під сумнів. Те саме розширення контекстного вікна, яке непомітно змінило те, що LLM може тримати в пам'яті, зробило простішу, швидшу й часто дешевшу архітектуру реальним варіантом для широкого класу бізнес-задач. Питання в тому, чи підходить ваша конкретна база знань під цей клас — і відповідь безпосередньо впливає на витрати на інфраструктуру, затримку відповіді та інженерні години, які ваша команда витратить на підтримку системи наступні два роки.
Суперечка між RAG і CAG — це не технічна дискусія. Це бізнес-рішення про архітектуру, вдягнене в інженерний одяг. Прийміть його правильно — і ваша AI-система буде швидшою, дешевшою та простішою в обслуговуванні. Помиліться — і ви платите за складність, яка вам не потрібна. Або, що гірше, будуєте щось надто просте для задачі, яку маєте вирішити.
Що насправді роблять RAG і CAG
Обидва підходи вирішують одну фундаментальну проблему: велика мовна модель знає лише те, на чому її навчали. Внутрішні знання вашої компанії — специфікації продуктів, правила відповідності, СОП, таблиці цін — не потрапили до тих навчальних даних. Тому потрібен спосіб передати ці знання моделі саме в момент, коли вона відповідає на запитання.
RAG і CAG — це дві різні відповіді на те саме питання.
Як працює RAG
Retrieval-Augmented Generation ставиться до вашої бази знань як до бібліотеки. Коли користувач ставить запитання, система в реальному часі шукає в цій бібліотеці, витягує найрелевантніші документи й передає їх моделі разом з оригінальним запитом. Модель читає знайдене й генерує відповідь.
Пайплайн виглядає так:
- Користувач надсилає запит
- Запит перетворюється на векторне вкладення (математичне представлення)
- Запускається пошук за схожістю у векторній базі даних з проіндексованими знаннями
- Витягуються найрелевантніші фрагменти
- Ці фрагменти додаються до промпту
- LLM генерує відповідь на основі знайденого контенту
Конкретний приклад: Фармацевтична компанія веде постійно оновлювану базу результатів клінічних випробувань, записів про взаємодію препаратів і регуляторних подань — десятки мільйонів документів, які ростуть щотижня. Коли співробітник відділу медичних питань запитує "які протипоказання для сполуки X у пацієнтів з нирковою недостатністю?", система шукає в реальному часі, витягує три найрелевантніші зведення випробувань і генерує обґрунтовану відповідь. Жодна людина не може прочитати весь корпус; пошук — єдиний практичний варіант.
RAG потужний, коли база знань велика, постійно оновлюється або надто велика, щоб помістити її деінде. Юридична дослідницька платформа, що працює з мільйонами статутів і судових справ, фінансова установа, якій потрібні актуальні ринкові дані у відповідях — це природне середовище RAG.
Компроміс: RAG додає інфраструктуру. Потрібне векторне сховище (Pinecone, Weaviate, pgvector або подібне), пайплайн ембедингів, шар пошуку й часто ранжувальник для покращення якості результатів. Кожен із цих компонентів може дати збій, деградувати або повернути не той документ. Помилки пошуку безпосередньо потрапляють у відповідь моделі.
Як працює CAG
Cache-Augmented Generation — формально представлений у грудні 2024 року дослідниками Браяном Дж. Чаном, Чао-Тін Ченом, Жуй-Хун Ченгом і Хен-Хсен Хуангом у статті "Don't Do RAG: When Cache-Augmented Generation is All You Need for Knowledge Tasks" — принципово інший підхід. Замість пошуку в момент запиту він завантажує всю релевантну базу знань у контекстне вікно моделі ще до того, як почнеться будь-яка взаємодія з користувачем.
Пайплайн простіший:
- Підготуйте й упорядкуйте документи зі знаннями
- Завантажте їх у контекстне вікно LLM (і за бажанням кешуйте KV-стан)
- У момент запиту модель уже має все необхідне — жодного кроку пошуку
- Відповідь генерується безпосередньо з попередньо завантаженого контексту
Конкретний приклад: Страхова компанія середнього розміру має 400-сторінковий посібник з полісів, стандартний FAQ із 300 поширеними запитаннями клієнтів і набір андерайтингових інструкцій, що оновлюються щоквартально. Весь корпус легко вміщується в сучасне контекстне вікно. Замість того щоб будувати пайплайн пошуку, команда один раз завантажує повну базу знань. Кожен запит агента — "чи покриває поліс типу B збитки від повені в підвалі?" — отримує відповідь менш ніж за пів секунди, без жодного шару пошуку, який міг би витягти не ту клаузулу.
Ключовий чинник — різке розширення контекстних вікон у сучасних LLM. Два роки тому більшість моделей могла обробляти обмежену кількість токенів. Сьогодні моделі на кшталт Gemini 1.5 Pro і Claude підтримують контекстні вікна від мільйона токенів і більше. База знань, яка колись вимагала повного пайплайну пошуку, тепер може просто завантажуватися.
Питання не в тому, яка архітектура краща. Питання в тому, яка відповідає формі ваших знань.
Оригінальне дослідження показало, що CAG досягає конкурентних результатів порівняно з розрідженими й щільними методами RAG на стандартних бенчмарках — бо коли повний контекст уже присутній, модель просто не може витягти не те. CAG усуває затримку пошуку, прибирає векторну базу даних зі стеку й обходить цілий клас помилок, що виникають через недосконале знаходження документів.
Обмеження настільки ж чітке: ваша база знань має вміщуватися в контекстне вікно, і вона має бути достатньо стабільною, щоб попередньо завантажений контекст не застарів до наступного оновлення.
RAG vs CAG: порівняння в одній таблиці
Перш ніж переходити до системи прийняття рішень, корисно побачити обидві архітектури поруч — за параметрами, що найбільше важать для бізнесу.
| Параметр | RAG | CAG |
|---|---|---|
| Принцип роботи | Шукає релевантні документи у зовнішньому сховищі в момент запиту | Завантажує всю базу знань у контекст моделі до надходження запитів |
| Розмір бази знань | Необмежений — масштабується до мільйонів документів | Обмежений контекстним вікном моделі (до ~1M токенів у топових моделях) |
| Актуальність знань | Завжди свіжа — витягує живі дані при кожному запиті | Потребує циклу оновлення при зміні знань |
| Частота оновлень | Щоденні або в реальному часі | Щомісячні або щоквартальні |
| Затримка відповіді | Вища — ембединг + пошук + ранжування додають час | Нижча — жодного кроку пошуку, одразу генерація |
| Складність інфраструктури | Висока — векторне сховище, пайплайн ембедингів, шар пошуку, ранжувальник | Низька — векторна база не потрібна |
| Ризик помилки пошуку | Є — неправильні фрагменти можуть потрапити у відповідь | Усунутий — повний контекст завжди доступний |
| Профіль витрат | Вищі витрати на запит (обчислення ембедингів + пошук) | Вищі витрати на початкове завантаження контексту; нижчі на запит |
| Підходить для | Великих, динамічних або непередбачуваних баз знань | Обмежених, стабільних, чітко визначених предметних областей |
| Типові кейси | Юридичні дослідження, живі ринкові дані, бази клінічних випробувань, актуальні залишки | Внутрішні СОП, FAQ продуктів, посібники з полісів, фреймворки відповідності |
Використовуйте цю таблицю як перший фільтр. Якщо ваша ситуація чітко відповідає одному стовпцю — рішення вже прийнято. Якщо відповідає обом — частина знань стабільна, частина жива — ви дивитеся на гібрид, про який йдеться в останньому розділі.
Система прийняття рішень: чотири питання перед початком розробки
Жодна архітектура не є універсально кращою. Правильний вибір прямо випливає з природи ваших знань і операційних вимог. Дайте відповідь на ці чотири питання, перш ніж команда напише перший рядок коду.
Питання 1: Який розмір вашої бази знань?
Це перший фільтр. Якщо ваша база знань — каталог продуктів, внутрішні СОП, документація з відповідності, HR-політики — вміщується в кілька сотень тисяч токенів, CAG заслуговує серйозного розгляду. Якщо ви маєте справу з мільйонами документів, постійно зростаючим корпусом або даними, що охоплюють кілька предметних областей, RAG — єдиний практичний варіант.
Корисний орієнтир: якщо вся ваша база знань помістилася б у довгий PDF, який людина-експерт могла б прочитати за день, вона, мабуть, вміщується в сучасне контекстне вікно.
Питання 2: Як часто змінюються ваші знання?
CAG потребує циклу оновлення. Щоразу, коли база знань змінюється, потрібно перезавантажити контекст (і перекешувати KV-стан, якщо ви використовуєте цю оптимізацію). Якщо дані змінюються щодня або в реальному часі — актуальні залишки, поточні ціни, свіжі регуляторні оновлення — ця накладна вартість стає проблемою. RAG витягує свіжі дані при кожному запиті за своєю природою.
Якщо знання змінюються щоквартально, щомісяця або навіть щотижня, вартість оновлення CAG цілком прийнятна. Якщо щогодини — RAG правильний інструмент.
Приклад: Правила оптимізації маршрутів і контракти з перевізниками логістичної компанії оновлюються двічі на рік. Це зручний для CAG цикл оновлення. Дані відстеження відправлень тієї самої компанії змінюються щохвилини — вони йдуть через RAG.
Питання 3: Наскільки передбачувані ваші запити?
CAG найкраще працює, коли можна передбачити форму запитань користувачів. Якщо 90% запитів потрапляють у чітко визначену предметну область — "яка наша політика повернення", "які характеристики продукту X", "що говорить пункт 7 нашого стандартного контракту" — попереднє завантаження цієї області дає моделі все необхідне.
RAG виправдовує свою складність, коли запити непередбачувані, міждоменні або вимагають синтезу інформації з документів, які неможливо знати заздалегідь.
Приклад: Технічні спеціалісти з обслуговування виробничої компанії ставлять передбачувані запитання про конкретні моделі обладнання — крутні моменти, коди помилок, інтервали обслуговування. Посібники з обладнання стабільні й обмежені. CAG справляється з цим чисто. Відділ закупівель тієї самої компанії ставить відкриті запитання, що охоплюють бази постачальників, ціни на сировину й регуляторні документи з кількох юрисдикцій — це вже територія RAG.
Питання 4: Що для вас означає затримка?
Відповіді CAG швидші. Без кроку пошуку модель одразу переходить до генерації. Для клієнтських застосунків, де час відповіді безпосередньо впливає на задоволеність — чат-бот підтримки, асистент з продажу, внутрішній helpdesk — ця різниця в швидкості відчутна й вимірювана. Для бек-офісних аналітичних задач, де затримка в дві секунди не має значення, це менш важливо.
Швидкість — не лише метрика користувацького досвіду. У середовищах з великим обсягом запитів скорочення середнього часу відповіді на 1,5 секунди безпосередньо впливає на пропускну здатність: більше запитів на годину, менше ескалацій, менший тиск на персонал.
Реальний кейс: що відбувається при переході
Вибір архітектури має прямі фінансові наслідки. Розглянемо роздрібну компанію середнього розміру, яка побудувала свій AI для обслуговування клієнтів на повному RAG-пайплайні. Кожен вхідний запит підтримки — включно з рутинними запитаннями про терміни доставки, умови повернення й розміри продуктів — запускав живий пошук по базі продуктів. Пошук був точним, але дорогим: кожен запит генерував витрати на обчислення ембедингів, векторний пошук і ранжування.
Команда проаналізувала журнали запитів і виявила, що приблизно 80% усіх вхідних запитань можна відповісти зі стабільного, обмеженого набору знань: FAQ, політика повернення, специфікації продуктів для топ-200 SKU. Ці знання легко вміщувалися в сучасне контекстне вікно.
Вони перенесли ці 80% обсягу запитів на архітектуру CAG, залишивши RAG лише для решти 20% — запитів про актуальні залишки, поточні акції та статус замовлень, які справді потребували пошуку в реальному часі. Результат: операційні витрати на AI-систему впали приблизно на 60%, а середня затримка відповіді знизилася з двох секунд до менш ніж пів секунди для більшості запитів. Інженерна команда, звільнена від налаштування якості пошуку для рутинних запитань, перенаправила цей час на вдосконалення RAG-шару для справді динамічних кейсів.
Це не історія про перемогу CAG над RAG. Це історія про відповідність архітектури реальній формі задачі — і про фінансовий важіль, який виникає, коли ця відповідність досягнута.
Керівники, які прийняли це рішення, не просто скоротили витрати. Вони прийшли на наступну зустріч з радою директорів з конкретною історією: витрати на AI-інфраструктуру знизилися на 60%, якість відповідей зросла, інженерний ресурс перенаправлено на роботу з вищою цінністю. Саме такі рішення змінюють сприйняття команди керівництва — не як людей, що впровадили AI за модою, а як операторів, які розуміють його достатньо, щоб змусити працювати ефективніше. Інвестори й ради директорів дедалі чіткіше розрізняють ці дві категорії. Архітектурне рішення — один із найяскравіших сигналів того, до якої ви належите.
І є щось тихіше, що відбувається по той бік цього рішення: операційна тривога від системи, яка дорога, повільна й важко пояснювана, зникає. Коли AI-інфраструктура правильно розмірована, ви перестаєте гасити пожежі й починаєте керувати курсом. Цей перехід — від реактивного до навмисного — і є тим, що відчувається як контроль над операціями.
Гібридна архітектура: коли потрібні обидва підходи
Для багатьох компаній середнього й великого розміру найпрактичніша відповідь — не бінарний вибір, а багаторівнева система, яка розподіляє запити на основі їхніх характеристик.
Патерн виглядає так:
- Базові, стабільні знання (специфікації продуктів, внутрішні політики, стандартні процедури, регуляторні фреймворки, що оновлюються щоквартально) → завантажуються через CAG для миттєвої відповіді
- Динамічні, актуальні знання (живі залишки, поточні ринкові дані, свіжі регуляторні зміни, статус замовлень) → обслуговуються через RAG з живим пошуком
Приклад у рітейлі: Роздрібна компанія з електронікою завантажує специфікації продуктів, умови гарантії й FAQ через CAG для свого асистента підтримки клієнтів. Той самий асистент використовує RAG для отримання поточних залишків і активних акцій. Клієнти отримують відповіді на запитання про продукти за долі секунди; система все одно точно відповідає на "чи є це в наявності в найближчому магазині?".
Приклад у виробництві: Посібники з обладнання й процедури безпеки — контент, що рідко змінюється — живуть у CAG-шарі. Збої в ланцюжку постачань і регуляторні оновлення, що можуть змінюватися щодня, йдуть через RAG. Технічні спеціалісти отримують миттєві відповіді прямо на виробничому майданчику; відділ закупівель отримує актуальні дані, коли вони потрібні.
Приклад у професійних послугах: Консалтингова компанія завантажує свої методологічні фреймворки, стандартні шаблони контрактів і внутрішню базу знань через CAG. Дані клієнтів, живі регуляторні документи й поточні ринкові дослідження надходять через RAG. Старші консультанти швидко отримують відповіді на внутрішні процесні запитання; клієнтський аналіз спирається на живі джерела.
Логіка маршрутизації не має бути складною. Простий класифікатор, який відносить вхідні запити до "стабільної предметної області" або "динамічної предметної області", часто цілком достатній. Головне — щоб рішення приймалося свідомо, на основі реальних характеристик ваших даних, а не за замовчуванням до тієї архітектури, яку команда вже знає.
Для глибшого розуміння того, як структуровані системи знань можуть забезпечити такий вид інтелектуальної маршрутизації, варто прочитати статтю про Knowledge Graph AI: як він керує бізнесом разом із цією.
Часті запитання
У чому головна різниця між RAG і CAG? RAG витягує релевантні документи із зовнішньої бази знань у момент запиту й передає їх моделі. CAG завантажує всю релевантну базу знань у контекстне вікно моделі ще до надходження будь-яких запитів. RAG краще для великих, динамічних знань; CAG — для менших, стабільних знань, що вміщуються в контекстний ліміт моделі.
Коли бізнесу варто обрати CAG замість RAG? CAG — сильніший вибір, коли ваша база знань обмежена за розміром, змінюється рідко (щомісяця або щоквартально, а не щодня) і більшість запитів передбачувані й потрапляють у чітко визначену предметну область. Він також кращий, коли затримка відповіді є пріоритетом і ви хочете мінімізувати складність інфраструктури.
Чи замінює CAG RAG повністю? Ні. CAG доповнює RAG, а не замінює його. Для баз знань, що надто великі для контекстного вікна або оновлюються в реальному часі, RAG залишається єдиним практичним варіантом. Багато виробничих систем використовують обидва: CAG для стабільних, часто запитуваних типів і RAG для динамічних або непередбачуваних інформаційних потреб.
Який розмір контекстного вікна потрібен для CAG? Залежить від розміру вашої бази знань. Сучасні топові моделі — включно з Gemini 1.5 Pro, Claude 3.5 і GPT-4o — підтримують контекстні вікна від 128 000 до понад мільйона токенів. Вікно в 128K токенів може вмістити приблизно 90 000–100 000 слів тексту, що покриває великий FAQ, повний каталог продуктів для сфокусованої лінійки або повний набір внутрішніх СОП для більшості відділів.
Які головні ризики CAG? Основні ризики — застарілість контексту (якщо база знань змінилася, а контекст не оновлено) і деградація при великому контексті (деякі моделі показують знижену точність, коли працюють біля верхньої межі свого контекстного ліміту). Обидва ризики керовані при правильному плануванні оновлень і підготовці бази знань, але вимагають свідомої операційної дисципліни.
Чи складно будувати гібридну RAG/CAG-систему? Основна складність — у логіці маршрутизації запитів: вирішити, які запити йдуть до CAG-шару, а які запускають RAG-пошук. Сама маршрутизація може бути такою простою, як ключовий класифікатор, або такою складною, як невелика модель виявлення намірів. Базові компоненти (попередньо завантажений контекст для CAG, векторне сховище для RAG) добре підтримуються існуючими фреймворками на кшталт LangChain і LlamaIndex.
Справжня навичка тут — не обрати сторону. А провести аудит: який розмір вашої бази знань, як часто вона змінюється і як насправді виглядає розподіл ваших запитів? Більшість компаній, що за замовчуванням використовують RAG для всього, не ставили цих питань. Деякі з них запускають дорогі пайплайни пошуку на базах знань, які вмістилися б в одне контекстне вікно.
Коли у вас є ці відповіді, вибір архітектури стає очевидним — і бізнес-кейс теж. Якщо ви зараз будуєте або оцінюєте AI-систему, порівняйте свою ситуацію з фреймворком вище. Рішення, яке ви приймете на рівні архітектури, визначить ваші витрати, затримку й навантаження на підтримку на роки вперед. Варто зробити це правильно ще до написання першого рядка коду.
Для команд, що думають про те, як виміряти й обґрунтувати інвестиції в будь-якому випадку, стаття AI ROI: як довести цінність бізнесу пропонує практичний підхід до побудови цього обґрунтування.
Є питання? Запитайте AI-агента прямо зараз
Відповідає за секунди, знає все про наші послуги та допоможе розібратися у вашій ситуації
Читайте також
Qwen3Guard: безпека AI у реальному часі
Qwen3Guard-Stream модерує відповіді LLM на рівні токенів під час генерації — не після. Архітектура, розміри моделей і бізнес-наслідки для B2B-продуктів.
Технічні гайдиGoogle DiffusionGemma: AI без навчання з нуля
DiffusionGemma від Google DeepMind змінює правила: fine-tuning замість дорогого навчання, Apache 2.0, 1000+ токенів/с і локальний деплой без хмарних API.
Технічні гайдиВаші корпоративні дані в Claude потрапили до Google
Shared chats і Artifacts Claude виявились індексованими Google. Розбираємо, які бізнес-дані витікають через AI та як закрити ці прогалини.