
DeepSeek-V4: мільйон токенів за копійки
DeepSeek-V4-Pro обробляє мільйон токенів за $0.66 — у рази дешевше за Anthropic і OpenAI. Розбираємо ціни, архітектуру і що це змінює для бізнесу.
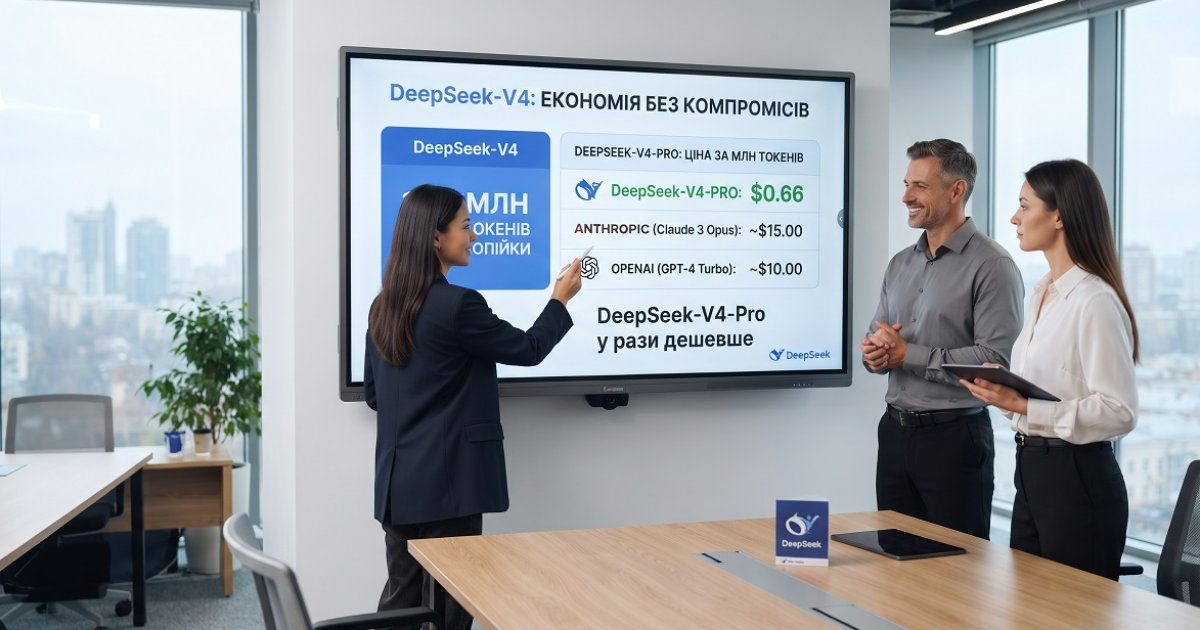
Ціна на «прочитати все» щойно впала
Мільйон токенів — це приблизно 750 000 слів, або сім повноцінних романів, оброблених за один виклик API. DeepSeek-V4-Pro робить це за $0.66 на мільйон вхідних токенів у позапіковий час. Найближчий закритий конкурент бере в рази більше за частку цього контексту. Математика корпоративного AI щойно змінилася.
Що це відкриває для бізнесу, який працює з великими контрактами, масивами комплаєнс-документів або розподіленими базами знань — це зсув, який не оголошує себе гучно. Він з'являється тихо у щомісячному рахунку за API, а потім — у вашій конкурентній позиції. Конкретика: хто виграє, хто програє і як виглядає реальне порівняння цін між провайдерами — варто розібрати уважно, перш ніж ухвалювати наступне інфраструктурне рішення.
Роками практична стеля того, що можна подати AI-моделі за один раз, трималася на рівні 128 000 токенів — достатньо для довгого звіту, але не для цілого архіву контрактів. Усе більше вимагало чанкінгу, пайплайнів пошуку і супутніх інженерних витрат. DeepSeek змінив цю логіку 24 квітня 2026 року, випустивши сімейство V4: дві відкриті Mixture-of-Experts моделі — V4-Pro і V4-Flash — обидві з контекстним вікном у мільйон токенів за замовчуванням, а не як платна опція.
Це не маргінальне оновлення. Це інша категорія інструменту — і ціни, що до нього додаються, змушують серйозно запитати: чи виправданий преміум, який досі беруть усталені гравці?
Що таке DeepSeek-V4 насправді
Дві моделі, одна архітектурна зміна
За офіційним анонсом DeepSeek, сімейство V4 складається з двох варіантів. V4-Pro має 1,6 трильйона параметрів загалом і 49 мільярдів активних на токен. V4-Flash — легший варіант: 284 мільярди параметрів і 13 мільярдів активних. Обидві вийшли під ліцензією MIT — тобто бізнес може розгортати їх на власній інфраструктурі без ліцензійних відрахувань — і обидві нативно підтримують контекстне вікно 1 048 576 токенів з максимальним виводом до 384 000 токенів.
Архітектура за цим справді нова. Попередні довгоконтекстні моделі впиралися в стелю, бо обчислення уваги масштабується квадратично від довжини послідовності — обробляти мільйон токенів наївним способом непомірно дорого. Інженерна команда DeepSeek вирішила це гібридним механізмом уваги, що поєднує Compressed Sparse Attention (CSA) і Heavily Compressed Attention (HCA). Згідно з технічним звітом DeepSeek, у режимі 1M токенів V4-Pro потребує лише 27% FLOP-ів одиночного інференсу і лише 10% KV-кешу порівняно з попередником — DeepSeek-V3.2. Саме цей виграш в ефективності робить такі ціни можливими.
Модель також нативно інтегрована з провідними фреймворками для AI-агентів, зокрема Claude Code і OpenCode, і підтримує формати OpenAI ChatCompletions та Anthropic API — міграція з наявних стеків потребує мінімальних змін.
Відкриті ваги змінюють рівняння самохостингу
Ліцензія MIT важить більше, ніж здається. Бізнес, який запускає V4-Flash на власній інфраструктурі при повному завантаженні GPU, може опустити вартість інференсу нижче будь-якого хостингового API-тарифу. Для організацій із вимогами до резидентності даних — охорона здоров'я, фінанси, юриспруденція — самохостинг часто не просто економія, а питання комплаєнсу. Відкриті ваги роблять цей шлях реальним без втрати продуктивності.
Справжній зсув — не саме контекстне вікно. А те, що мільйон токенів тепер є базовим — не преміум-рівнем, не спеціальною конфігурацією. Базова лінія змістилася.
Ціновий розклад: провайдер за провайдером
Цифри тут важливі, тому — точно. Усі дані нижче відображають публічно задокументовані API-тарифи станом на середину 2026 року і можуть змінюватися.
DeepSeek V4-Pro (позапіковий час): $0.66 за мільйон вхідних токенів, $1.98 за мільйон вихідних. Кеш-хіти коштують значно менше — DeepSeek застосовує автоматичне кешування промптів, і вхідний токен при кеш-хіті обходиться приблизно в 1/120 від стандартного тарифу. Для повторюваних запитів до одного й того самого документа — скажімо, одного комплаєнс-файлу, до якого звертаються сотні разів на день — вхідна вартість фактично наближається до нуля.
DeepSeek V4-Flash (позапіковий час): $0.15 за мільйон вхідних токенів, $0.60 за мільйон вихідних. Кеш-хіти падають приблизно до $0.003 за мільйон — на 98% нижче від тарифу без кешу.
Для порівняння: Anthropic Haiku 4.5 — модель середнього рівня, не флагман — коштував $1 за мільйон вхідних і $5 за мільйон вихідних токенів. DeepSeek V4-Flash виходить приблизно вдвічі дешевший на вході і майже у вісімнадцять разів — на виході, за опублікованими даними. Моделі рівня Claude Opus коштують суттєво більше.
На боці OpenAI цінова картина швидко змінюється, але навіть знижені тарифи залишаються помітно дорожчими за позапікові ставки DeepSeek для еквівалентних довжин контексту.
Важливий нюанс: деякі провайдери застосовують надбавку за довгий контекст, коли промпт перевищує 200 000 токенів. Gemini, наприклад, подвоює тариф після цієї позначки. DeepSeek жодної надбавки не застосовує — мільйонне вікно тарифікується рівно.
| Модель | Вхід ($/M токенів) | Вихід ($/M токенів) | Контекстне вікно |
|---|---|---|---|
| DeepSeek V4-Pro (позапік) | $0.66 | $1.98 | 1M токенів |
| DeepSeek V4-Flash (позапік) | $0.15 | $0.60 | 1M токенів |
| Anthropic Haiku 4.5 | $1.00 | $5.00 | 1M токенів |
| OpenAI GPT-6 Luna | ~$0.10–$0.20 | ~$0.50–$1.20 | varies |
Тарифи приблизні і відображають публічно доступну документацію; перевіряйте актуальні ціни перед закупівельними рішеннями.
Варто зазначити: станом на кінець вересня 2026 року OpenAI GPT-6 Luna виставлений агресивно і за деякими метриками підрізає DeepSeek V4-Flash — конкурентний тиск явно працює в обидва боки. Але головне залишається: епоха переплати в 10–30 разів за довгоконтекстну обробку добігає кінця.
Що мільйон токенів реально відкриває для бізнесу
Документоємні операції
Найочевидніший сценарій — будь-який процес, де вузьке місце полягає в обсязі тексту, який AI має побачити за раз. Юридичні команди, що аналізують угоди про злиття разом із регуляторними прецедентами. Відділи закупівель, які звіряють багаторічні контракти з постачальниками з поточними комплаєнс-вимогами. Фінансові команди, що зіставляють аудиторські сліди з політиками.
Раніше такі процеси вимагали RAG-пайплайнів — чанкінгу документів, їх ембедингу, пошуку релевантних фрагментів і надії, що крок пошуку нічого не пропустить. RAG потужний, але вносить помилки пошуку й інженерну складність. З реальним мільйонним вікном можна завантажити весь масив документів у контекст і дати моделі міркувати над ним напряму. Про те, коли RAG все ще доречний, а коли повноконтекстний підхід виграє, детально розібрано в матеріалі RAG vs CAG: яку AI-архітектуру обрати.
Агентні процеси і багатокрокова автоматизація
В офіційному анонсі DeepSeek підкреслює позицію V4 як відкритого state-of-the-art у бенчмарках агентного кодування. Практичний висновок виходить за межі коду: будь-який багатокроковий агентний процес, якому потрібно зберігати стан протягом тривалого завдання — агент закупівель, що веде переговорний трек, або комплаєнс-агент, що аудитує зміну політики в десятках документів — прямо виграє від більшого контекстного вікна. Агент не втрачає нитку.
Згідно з технічною документацією, V4 вже рухає внутрішнє агентне кодування в самому DeepSeek — це вагомий сигнал про готовність до продакшну.
Консолідація баз знань
Для бізнесу, що тримає розрізнені системи знань — окремі вікі, нотатки CRM, історії тікетів підтримки, документацію продукту — мільйон токенів означає, що AI-агент може тримати всю релевантну базу знань у робочій пам'яті для одного запиту. Консолідація, яка раніше вимагала місяців дата-інженерії, тепер наближається через добре структурований промпт. Це особливо актуально для підходів на основі Knowledge Graph і AI-автоматизації бізнесу, де якість міркувань напряму залежить від того, скільки контексту модель може охопити одночасно.
Модель, що читає весь архів контрактів за один виклик, не просто економить час. Вона усуває цілу категорію ризику: ризик того, що крок пошуку пропустив саме той пункт, який мав значення.
Реальний розрахунок вартості: за межами ціни за токен
Заголовні ціни на токени — це відправна точка, а не фінальна. Три фактори суттєво впливають на реальний рахунок.
Кешування промптів — найбільший важіль. Якщо застосунок надсилає один і той самий великий документ або системний промпт знову і знову — а саме так і відбувається в продакшн-агентних деплойментах — кешовані токени коштують частку від свіжих. Ставка кеш-хіту на V4-Flash — приблизно на 98% нижче стандартної вхідної ціни. Для процесу, що обробляє один і той самий 500-сторінковий документ тисячу разів на день, ефективна вартість запиту на вхідній стороні падає до майже нуля.
Піковий і позапіковий тариф — новий нюанс. DeepSeek запровадив диференційоване ціноутворення у серпні 2026 року: тарифи приблизно подвоюються в пікові години. Для пакетних навантажень — нічні комплаєнс-перевірки, генерація звітів наприкінці дня — планування на позапіковий час скорочує рахунок удвічі без жодних змін у самому процесі.
Економіка самохостингу застосовна, якщо є відповідна інфраструктура. Запуск V4-Flash на власних або орендованих GPU при достатньому завантаженні може опустити витрати нижче будь-якого хостингового API-тарифу. Ліцензія MIT знімає юридичні перешкоди, які інакше ускладнили б цей шлях.
Практичний висновок: для бізнесу, що масштабно обробляє великі документи, сукупна вартість DeepSeek V4 з кешуванням і позапіковим плануванням — це не просто дешевше за альтернативи. Це інший порядок величини. А різниця фінансує реальні кадри або продуктові інвестиції.
Структурований підхід до розрахунку AI ROI за цими змінними детально описаний у матеріалі AI ROI: як довести цінність бізнесу.
Як обрати між V4-Pro і V4-Flash
Рішення нескладне, якщо зіставити його з типом навантаження.
V4-Pro — правильний вибір, коли якість міркувань є обмежувальним фактором: складний юридичний аналіз, багатокрокове фінансове моделювання, генерація коду в масштабних кодових базах або будь-яке завдання, де помилка має наслідки далі по ланцюжку. За $0.66 на мільйон вхідних токенів у позапіковий час він все одно разюче дешевший за порівнянні закриті моделі, а 49 мільярдів активних параметрів дають продуктивність, близьку до фронтиру, на математичних, STEM- і кодових бенчмарках.
V4-Flash — правильний вибір, коли пропускна здатність і вартість є головними змінними: масова класифікація документів, первинний перегляд контрактів, тріаж клієнтської підтримки або будь-який процес, де йдуть мільйони запитів і можна допустити дещо нижчу глибину міркувань. За $0.15 на мільйон вхідних токенів у позапіковий час, з кеш-хітами, що наближаються до нуля, — це найбільш економічний шлях до великоконтекстної обробки через хостинговий API.
Практична архітектура для багатьох компаній: складні, критичні запити — до V4-Pro, масові, менш критичні — до V4-Flash. Той самий формат API, те саме контекстне вікно, різні цінові профілі.
Що це означає для вашої AI-стратегії
Поява доступного мільйонного контексту змінює розрахунок за кількома рішеннями, які багато компаній відкладали.
По-перше, знижується поріг для AI-автоматизації документоємних процесів. Комплаєнс-перевірка, аналіз контрактів, управління знаннями — процеси, які здавалися надто складними або ризикованими для автоматизації, бо AI не бачив достатньо контексту, щоб бути надійним, — стають реальними. Технічним бар'єром було контекстне вікно. Цей бар'єр тепер прибраний ціною.
По-друге, позиція «почекаємо, поки технологія дозріє» більше не тримається. Технологія дозріла. Питання вже не в тому, чи впорається AI з вашим обсягом документів — а в тому, чи є у вашої організації процеси для відповідального деплойменту.
По-третє, змінюється динаміка переговорів із вендорами. Коли потужна відкрита модель доступна під ліцензією MIT, важелі в розмовах із закритими провайдерами зміщуються. У вас є реальна альтернатива, і провайдери це розуміють.
Керівники, які розпізнають цей зсув раніше — і перебудують стратегію AI-закупівель під нову цінову реальність, а не під припущення 2024 року — виявлять, що пояснюють раді директорів, чому їхні AI-операційні витрати становлять частку від конкурентських. Це розмова, яку варто провести. Не тому що вона демонструє технічну витонченість, а тому що вона демонструє системне мислення, яке перетворює інфраструктурні рішення на стійкі конкурентні переваги.
Відчуття від роботи критичних бізнес-процесів на AI, який справді бачить повну картину — а не витягнутий фрагмент — якісно відрізняється від того, що більшість організацій мали досі. Це різниця між аналітиком, який переглянув документ по діагоналі, і тим, хто прочитав кожну сторінку. Таку впевненість, раз отримавши, важко відпустити.
FAQ
Яке контекстне вікно у DeepSeek-V4-Pro і чому це важливо? DeepSeek-V4-Pro підтримує контекстне вікно 1 048 576 токенів — приблизно мільйон токенів. Модель може обробити кілька повноцінних книг або цілий архів контрактів за один виклик API, що усуває потребу в чанкінгу або пошукових пайплайнах для більшості документоємних процесів.
Як ціни DeepSeek-V4 порівнюються з OpenAI і Anthropic? У позапіковий час DeepSeek V4-Flash коштує $0.15 за мільйон вхідних токенів і $0.60 за мільйон вихідних. Anthropic Haiku 4.5 коштував $1 за мільйон вхідних і $5 за мільйон вихідних — DeepSeek приблизно вдвічі дешевший на вході і у вісімнадцять разів — на виході. Ціни OpenAI варіюються залежно від моделі і швидко змінюються, але DeepSeek залишається серед найдешевших варіантів для великоконтекстних навантажень.
Чи підходить DeepSeek-V4 для корпоративного використання, зокрема самохостингу? Так. Обидві моделі — V4-Pro і V4-Flash — вийшли під ліцензією MIT, що дозволяє самохостинг без ліцензійних обмежень. Моделі підтримують формати API OpenAI і Anthropic, що мінімізує зусилля на міграцію. Для організацій із вимогами до резидентності даних або комплаєнсу самохостинг на власній інфраструктурі — реальний і економічно обґрунтований шлях.
У чому різниця між V4-Pro і V4-Flash? V4-Pro має 1,6 трильйона параметрів загалом (49 мільярдів активних на токен) і оптимізований для складних міркувань, кодування та аналізу з високими ставками. V4-Flash має 284 мільярди параметрів (13 мільярдів активних) і розрахований на високопропускні, чутливі до вартості навантаження. Обидві моделі мають однакове мільйонне контекстне вікно і ліцензію MIT.
Чи бере DeepSeek надбавку за довгі промпти понад певну довжину? Ні. На відміну від деяких провайдерів, що застосовують надбавки для промптів понад 200 000 токенів, DeepSeek тарифікує повне мільйонне контекстне вікно за єдиною ставкою. Це структурна перевага для навантажень, що регулярно перевищують діапазон 128K–200K, де витрати конкурентів зростають.
Як кешування промптів впливає на реальну вартість DeepSeek-V4? DeepSeek застосовує автоматичне кешування промптів. Вхідні токени при кеш-хіті на V4-Flash коштують приблизно $0.003 за мільйон — на 98% нижче стандартного тарифу без кешу. Для продакшн-деплойментів, що повторно обробляють одні й ті самі великі документи або системні промпти, кешування може знизити ефективну вхідну вартість до майже нуля, роблячи сукупну вартість суттєво нижчою, ніж підказують заголовні тарифи.
Ціновий поріг для серйозних AI-можливостей щойно пробив дно. Компанії, які перекалібрують AI-бюджети й архітектури під нову реальність — а не під цінові припущення 2024 року — виявлять, що розрив між тим, що вони можуть автоматизувати, і тим, що конкуренти можуть собі дозволити, розширюється швидше, ніж хтось очікував. Цей розрив — стратегічний актив, і він доступний кожному, хто готовий порахувати.
Є питання? Запитайте AI-агента прямо зараз
Відповідає за секунди, знає все про наші послуги та допоможе розібратися у вашій ситуації
Читайте також
AI ROI: як довести цінність бізнесу
Seat counts і токени не переконають CFO. Ось покроковий фреймворк вимірювання AI-ROI через реальні бізнес-результати — з формулами та прикладами.
Ціни та ROIAI-реклама ROI: OpenAI переписує правила
OpenAI запустила Sponsored Agents, природномовне створення кампаній і інтеграції з HubSpot та Shopify. Що це означає для бюджету й команди.
Ціни та ROIGPT-6 Astra ROI: скільки коштують галюцинації
GPT-6 Astra знизив рівень галюцинацій з 12,2% до 4,2%. Рахуємо, скільки це реально економить для контент-, юридичних та аналітичних команд.